

Bot Traffic là lượng request do bot tạo ra (crawler, scraper, scanner) thay vì người dùng thật. Dùng khi website bị chậm, log “ngập bot”, số liệu GA4/GSC lệch, hoặc cần điều phối crawl budget để Google/AI quét đúng trang quan trọng.
Lợi ích chính: giảm tải hệ thống, giảm rác index, giữ đường crawl cho trang chuyển đổi, và tăng khả năng nội dung được AI trích dẫn đúng bối cảnh.
Tài liệu trả phí
Bản đầy đủ: Bot Traffic là gì - Chặn bot, nuôi bot, tối ưu AI cite
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 9.577 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 14 bước, bảng lỗi, mẫu, nghiệm thu (6 bảng)
- PDF: 26 trang, tải về
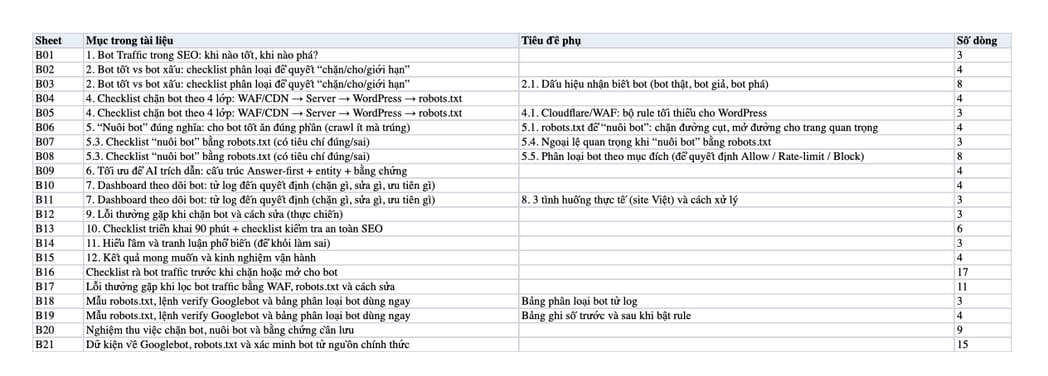
- Excel: 21 bảng và 88 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
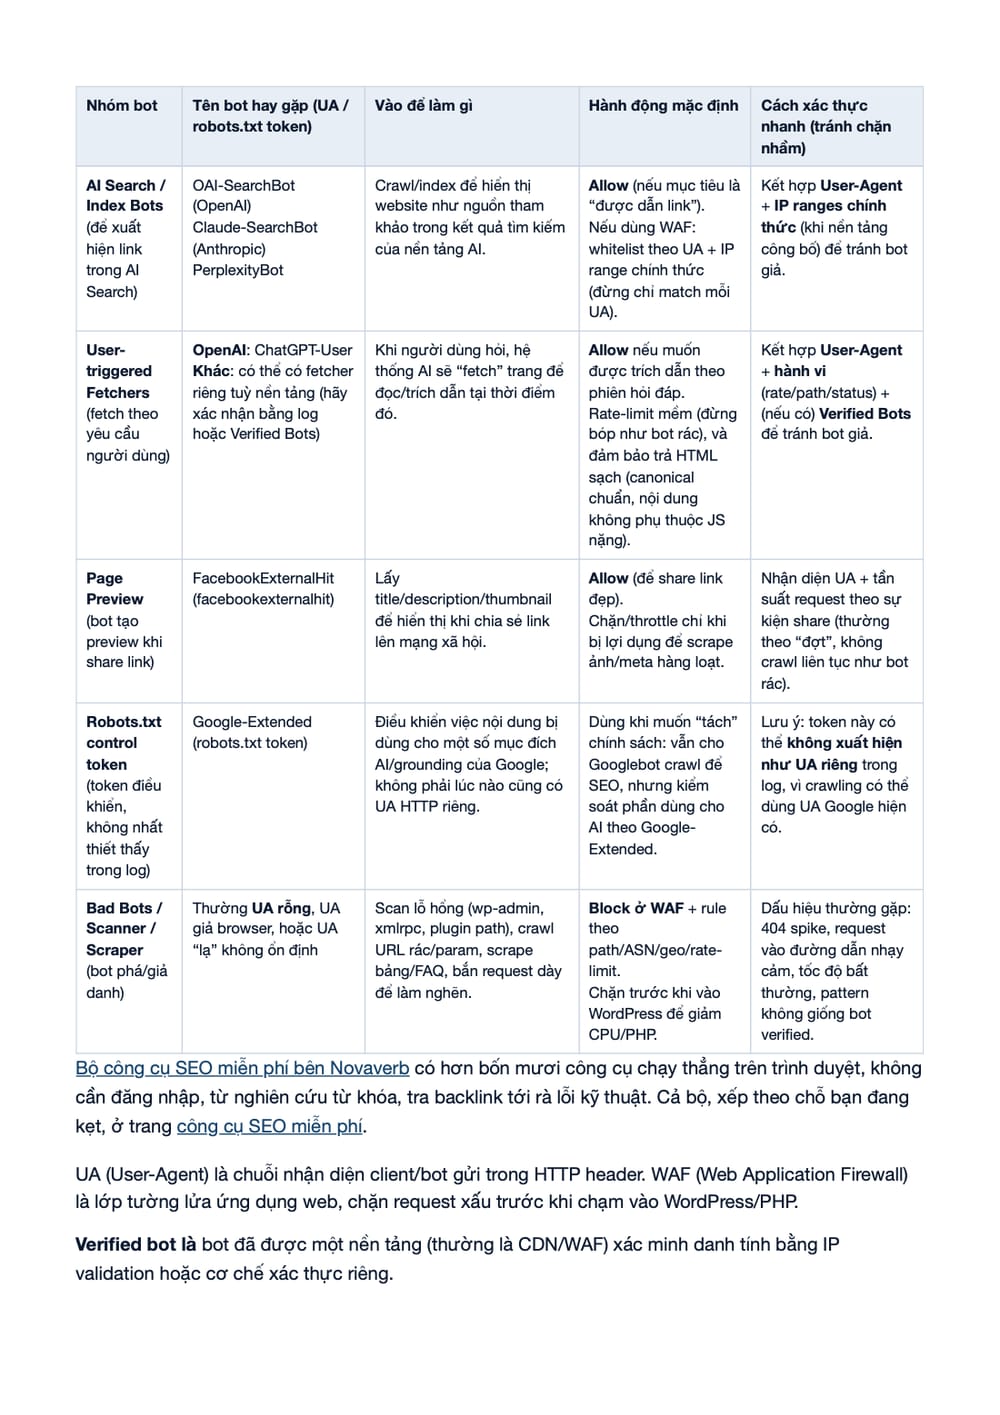
Xem trước bản đầy đủ: ba ảnh chụp từ chính tệp PDF và Excel bạn nhận sau khi mua.
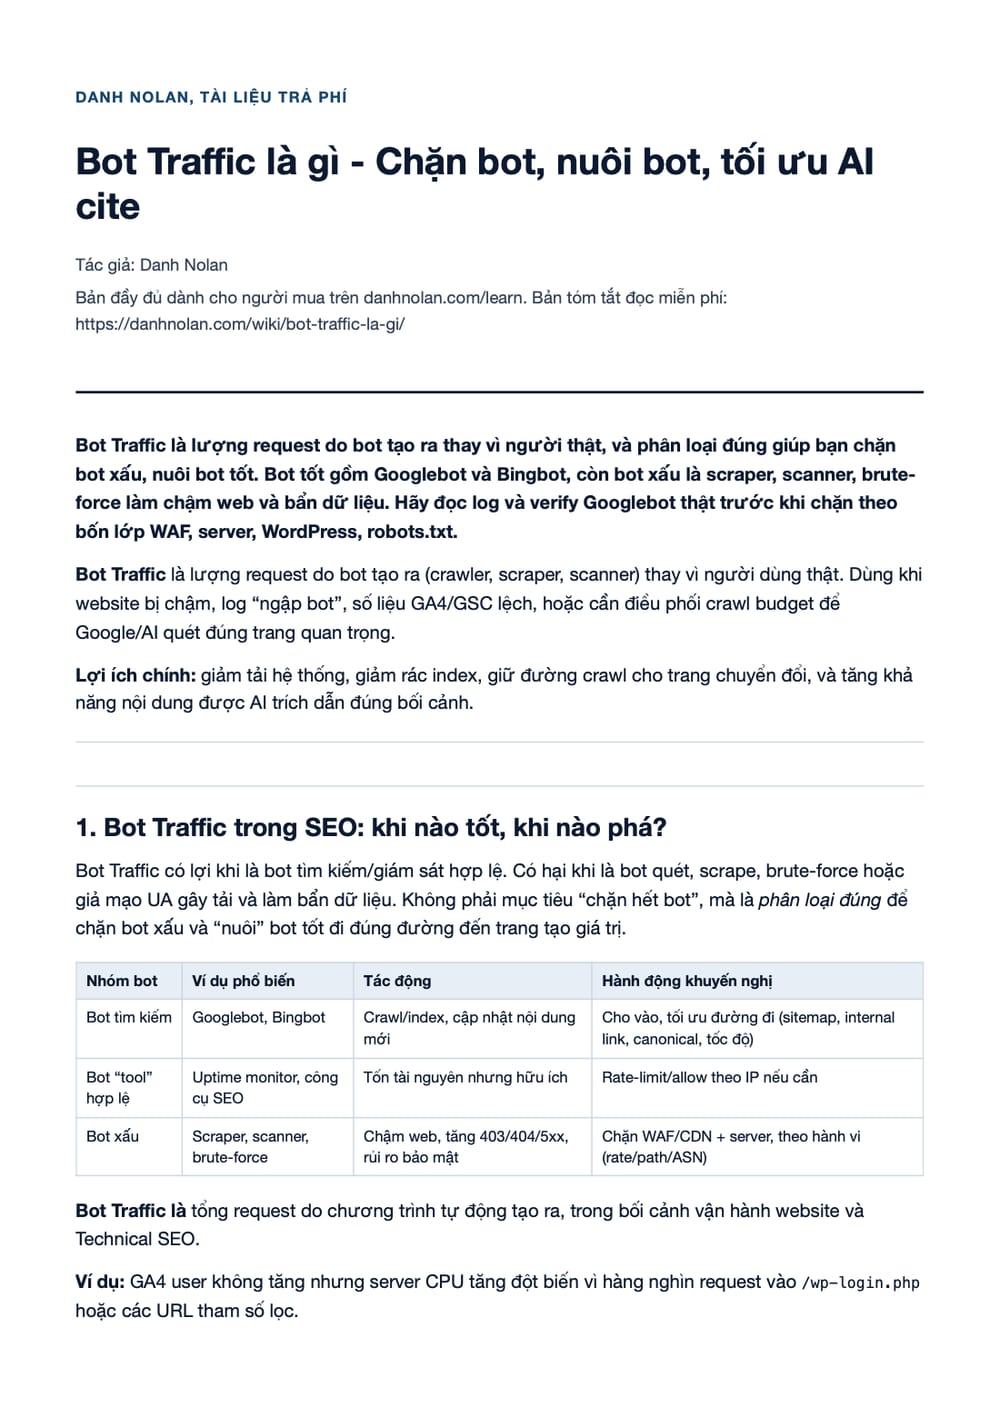
1. Bot Traffic trong SEO: khi nào tốt, khi nào phá?
Bot Traffic có lợi khi là bot tìm kiếm/giám sát hợp lệ. Có hại khi là bot quét, scrape, brute-force hoặc giả mạo UA gây tải và làm bẩn dữ liệu. Không phải mục tiêu “chặn hết bot”, mà là phân loại đúng để chặn bot xấu và “nuôi” bot tốt đi đúng đường đến trang tạo giá trị.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Nhóm bot, Ví dụ phổ biến, Tác động, Hành động khuyến nghị), 2 danh sách (tổng 5 dòng), mẫu để chép. Xem bản đầy đủ
Bot Traffic là tổng request do chương trình tự động tạo ra, trong bối cảnh vận hành website và Technical SEO.
Ví dụ: GA4 user không tăng nhưng server CPU tăng đột biến vì hàng nghìn request vào /wp-login.php hoặc các URL tham số lọc.
UA (User-Agent) là chuỗi thông tin mà trình duyệt hoặc bot gửi kèm trong mỗi HTTP request để “tự giới thiệu” nó là ai (loại phần mềm, hệ điều hành, đôi khi cả phiên bản). Trong bối cảnh Bot Traffic, UA hay được dùng để phân loại nhanh bot/trình duyệt, nhưng không đủ tin vì bot xấu có thể giả UA.
Ví dụ UA của trình duyệt (Chrome trên macOS):
Ví dụ UA của bot:
UA dùng khi nào trong thực chiến?
Chuỗi nhận dạng trình duyệt hữu ích để lọc nhanh nhật ký, xem chuỗi nào đang gọi nhiều và chuỗi nào sinh nhiều mã lỗi. Nó cũng đủ để chặn các trình quét phổ biến ở lớp máy chủ hoặc tường lửa. Nhưng nó không phải bằng chứng để mở cửa cho Googlebot, vì chuỗi đó ai cũng khai được.
Đúng khi / Sai khi
Ranh giới nằm ở chỗ có bao nhiêu tín hiệu cùng khớp. Đúng khi chuỗi nhận dạng, hành vi gồm tần suất, đường dẫn và mã trạng thái, cùng phần xác minh IP hoặc DNS đều chỉ về một hướng. Sai khi thấy chữ Googlebot rồi tin luôn, vì đó là dòng chữ dễ giả nhất trong toàn bộ nhật ký.
Nếu bạn paste 1-2 dòng log mẫu (IP + URL + status + UA), tôi sẽ chỉ ra ngay: UA đó “nghiêm túc” hay “đội mũ giả”.
2. Bot tốt vs bot xấu: checklist phân loại để quyết “chặn/cho/giới hạn”
Phân loại theo mục tiêu (crawl/index, giám sát, audit, tấn công) và theo hành vi (rate, path, status code) cho quyết định chính xác hơn UA. UA chỉ là “nhãn” và bị giả rất dễ. Hành vi + log mới là bằng chứng vận hành.
Bản đầy đủ của mục này có thêm: 2 bảng (tổng 12 dòng), 4 danh sách (tổng 19 dòng). Xem bản đầy đủ
Output: 1 bảng danh sách “Allow / Rate-limit / Block” theo UA/IP + 1 bảng “Top URL bị bot đập”.
2.1. Dấu hiệu nhận biết bot (bot thật, bot giả, bot phá)
Nhận biết bot chính xác nhất dựa vào hành vi (tần suất, đường dẫn, status code, pattern quét) hơn là chỉ dựa vào User-Agent. User-Agent có thể bị giả rất dễ. Bot thật thường có hành vi “có mục đích”, còn bot phá thường có hành vi “quét rộng, burst mạnh, đánh endpoint nhạy cảm”.
2.2. Checklist nhận biết bot trong 3 phút (không cần tool phức tạp)
Chỉ cần 4 câu hỏi: ai vào nhiều nhất, vào URL nào, tạo lỗi gì, và có burst không là đã phân loại được 80%. Mục tiêu là ra quyết định Allow/Rate-limit/Block nhanh, không phải ngồi “đọc log cho vui”.
Output: Danh sách 10 IP/UA đáng chú ý + nhãn hành động (Allow / Rate-limit / Block).
2.3. Dấu hiệu “bot giả danh Googlebot” (đừng allowlist nhầm)
Bot giả danh Googlebot thường lộ qua hành vi quét endpoint nhạy cảm, burst cao và tỷ lệ lỗi lớn. User-Agent ghi “Googlebot” không phải bằng chứng. Nếu một IP “Googlebot” mà lại hit /wp-login.php hoặc quét tham số loạn, đó gần như chắc chắn là bot giả.
Output: Danh sách IP tự xưng Googlebot cần verify DNS + danh sách IP fail verify để block.
2.4. Dấu hiệu “bot scrape content” (copy bảng, FAQ, đoạn ngon)
Bot scrape thường tập trung vào trang có bảng/FAQ, request theo pattern đều đặn và có thể lấy nhiều trang liên tiếp trong thời gian ngắn. Nếu thấy một IP/UA “đọc” quá nhiều bài có cấu trúc (bảng, FAQ) theo nhịp máy chạy, đó là tín hiệu scrape.
Output: Danh sách IP/UA scrape + rule WAF challenge/rate-limit + theo dõi hit theo giờ.
3. Đọc log để phân biệt bot thật và bot giả (không cần đoán mò)
Log giúp thấy ai đang ăn tài nguyên và đánh vào URL nào. Bot giả thường lộ qua burst + path bất thường + tỷ lệ lỗi cao. Nếu không đọc log, chặn sai rất dễ: chặn nhầm bot tốt hoặc bỏ sót bot xấu “nhìn như người”.
Output: 3 bảng: Top UA, Top URL, Top IP theo lỗi (403/404/429) để ra quyết định chặn.
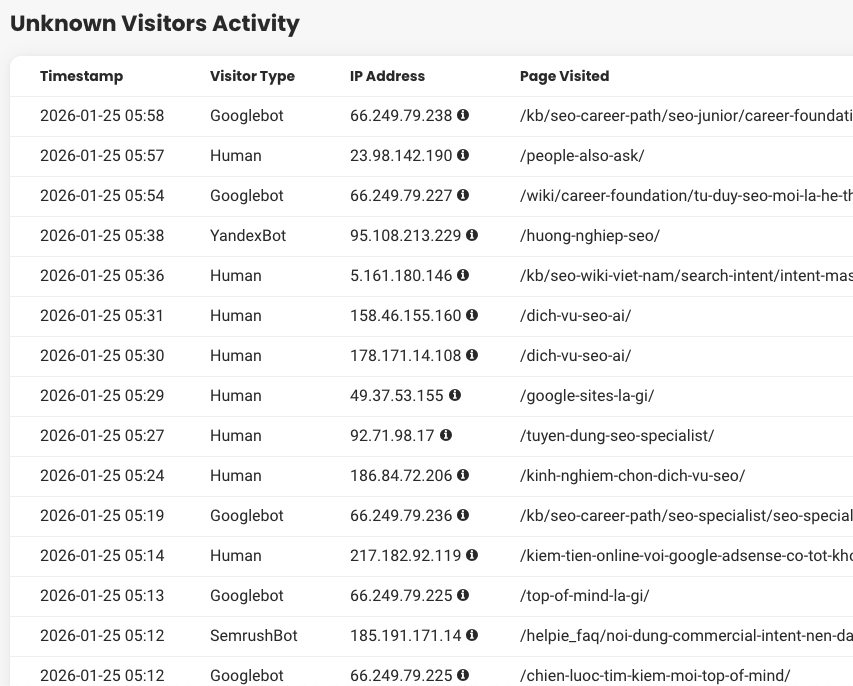
3.1. Lọc nhanh log (Nginx/Apache) để ra danh sách bot
Chỉ cần lọc 3 thứ: UA, URL, IP lỗi là đủ thấy 80% vấn đề bot traffic. Mục tiêu là tạo “danh sách hành động” (block/rate-limit/allow), không phải ngắm log.
Output: 3 danh sách Top 30: User-Agent, URL, IP theo lỗi.
Bản đầy đủ của mục này có thêm: danh sách 5 dòng, mẫu để chép. Xem bản đầy đủ
Nếu dùng Cloudflare và không có Nginx/Apache, vẫn làm được bằng cách xuất log/analytics từ Cloudflare rồi xử lý tương tự trong Sheets. Gợi ý đọc nền tảng: Log File Analysis.
3.2. Verify Googlebot thật trước khi chặn (tránh tự bắn chân)
UA “Googlebot” có thể bị giả. Cần xác minh bằng reverse DNS và forward DNS với các IP tự xưng Googlebot hit nhiều. Chỉ cần verify nhóm “ảnh hưởng SEO” (Googlebot/AdsBot), không cần verify mọi bot lặt vặt.
Output: danh sách IP Googlebot đã verify + danh sách IP giả để block.
4. Checklist chặn bot theo 4 lớp: WAF/CDN → Server → WordPress → robots.txt
Chặn càng gần “cửa” càng tốt: ưu tiên WAF/CDN, rồi mới tới server và WordPress. Robots.txt chỉ là lớp hướng dẫn bot tuân chuẩn. Nếu bot xấu bị chặn sau khi đã vào PHP/MySQL thì bạn vẫn trả “chi phí tài nguyên” cho nó.
Bản đầy đủ của mục này có thêm: 2 bảng (tổng 7 dòng), 2 danh sách (tổng 9 dòng), mẫu để chép. Xem bản đầy đủ
4.1. Cloudflare/WAF: bộ rule tối thiểu cho WordPress
Chặn brute-force và scanner ở WAF thường cho hiệu quả nhanh nhất: giảm request vào endpoint nhạy cảm và giảm lỗi 5xx. Rule tốt là rule “ít chữ”: tập trung vào path nhạy cảm + rate + hành vi.
Output: 1 rule rate-limit login, 1 rule block xmlrpc (nếu không dùng), 1 rule chặn file nhạy cảm.
4.2. Nginx: chặn endpoint nhạy cảm + rate-limit
Nginx phù hợp khi bạn đã có “danh sách vấn đề” từ log và cần cắt nhanh bot xấu theo path/rate. Ưu tiên chặn theo path trước; chặn theo UA chỉ dùng cho scanner phổ biến vì UA dễ bị giả.
Output: 1 snippet chặn xmlrpc + 1 rule rate-limit wp-login.
4.3. Apache/.htaccess: chặn cơ bản theo path và UA
Apache chặn nhanh theo rewrite rule, phù hợp shared hosting hoặc site nhỏ chưa có WAF. Luôn test phạm vi nhỏ và có khả năng rollback để tránh 403 nhầm.
Output: 1 nhóm rule chặn xmlrpc + 1 nhóm rule chặn scanner phổ biến.
4.4. WordPress: giảm bot rác vào PHP/MySQL
Với WP, bot rác thường đánh vào login/xmlrpc và tạo URL rác bằng search/param; dọn đúng giúp giảm tải PHP rõ. Nếu có WAF/server thì chặn trước; WP layer là lớp “phòng thủ cuối”.
Output: tắt/giới hạn xmlrpc (nếu không dùng), hardening login, hạn chế URL rác từ search/param.
4.5. robots.txt: mẫu thực chiến “chặn đường cụt” nhưng không chặn bừa
robots.txt nên chặn các đường dẫn nội bộ không cần Search và các pattern tạo crawl trap; đồng thời khai báo sitemap để bot tốt đi đúng map. Không nên dùng Disallow: /*?* cho mọi site vì có thể chặn nhầm trang hợp lệ có query; hãy chặn theo pattern rõ và kiểm bằng log.
Output: 1 robots.txt chạy được + danh sách pattern “cần chặn theo site”.
Tài liệu nội bộ liên quan: Robots.txt Optimization và Advanced Robots.txt Rules.
5. “Nuôi bot” đúng nghĩa: cho bot tốt ăn đúng phần (crawl ít mà trúng)
Nuôi bot đúng nghĩa là cho bot tốt crawl ít mà trúng: dùng robots.txt để chặn đường cụt và dẫn bot vào sitemap cùng khu vực nội dung có giá trị. Nên chặn theo pattern cụ thể lấy từ log như replytocom, orderby, add-to-cart, không chặn quét sạch /*?* vì dễ chặn nhầm URL hợp lệ.
5.1. robots.txt để “nuôi bot”: chặn đường cụt, mở đường cho trang quan trọng
robots.txt “nuôi bot” hiệu quả khi nó giúp bot tìm kiếm đi thẳng vào sitemap và khu vực nội dung có giá trị, đồng thời tránh các URL rác gây crawl trap. Ưu tiên chặn theo pattern cụ thể (dựa trên log), không chặn theo kiểu “quét sạch” /*?* vì dễ chặn nhầm URL hợp lệ.
Output: 1 file robots.txt chạy được + 1 danh sách “pattern cần chặn” lấy từ log (replytocom, orderby, add-to-cart, sort/filter rác...).
Bản đầy đủ của mục này có thêm: bảng 4 dòng (cột: Nhóm URL, Nên làm gì trong robots.txt, Vì sao, Kiểm bằng), mẫu để chép. Xem bản đầy đủ
5.2. robots.txt mẫu “nuôi bot” cho WordPress (an toàn, không chặn bừa)
Mẫu dưới đây giữ đường crawl sạch cho bot tìm kiếm: chặn khu vực admin và các “đường cụt” phổ biến, đồng thời khai báo sitemap để bot đi đúng map. Các dòng chặn tham số là dạng “bật khi cần”, chỉ dùng khi log cho thấy bị crawl nhiều hoặc tạo quá nhiều URL vô nghĩa.
Output: robots.txt (v1) + danh sách tham số cần chặn theo site.
5.3. Checklist “nuôi bot” bằng robots.txt (có tiêu chí đúng/sai)
Checklist này giúp robots.txt phục vụ đúng mục tiêu: bot tốt crawl đúng trang, bot không lãng phí vào URL rác. Mỗi thay đổi robots.txt đều phải có log trước/sau để tránh chặn nhầm.
Output: file robots.txt v2 + bảng đối chiếu “trước/sau” (Top URL bị hit, Googlebot hit money page).
Bản đầy đủ của mục này có thêm: 2 bảng (tổng 11 dòng), 4 danh sách (tổng 19 dòng). Xem bản đầy đủ
5.4. Ngoại lệ quan trọng khi “nuôi bot” bằng robots.txt
Không có một robots.txt “chuẩn cho mọi site”. Robots tốt là robots khớp hành vi URL thật của site và mục tiêu index. Các site có filter faceted navigation, tracking query, hoặc ecommerce thường có query hợp lệ. Chặn bừa sẽ làm mất crawl các trang có giá trị.
Gợi ý đọc nền tảng: Log File Analysis.
5.5. Phân loại bot theo mục đích (để quyết định Allow / Rate-limit / Block)
Phân loại bot theo “mục đích + mức độ tin cậy + mức tiêu tốn tài nguyên” giúp xử lý đúng: bot tìm kiếm thì nuôi, bot SEO tool thì giới hạn, bot xấu thì chặn. Không có “danh sách bot đầy đủ cho mọi website”, vì bot thay đổi liên tục. Cách đúng là dùng taxonomy (nhóm) + map theo log để ra quyết định.
Bảng này gắn tên bot (User-Agent / token) với mục đích và hành động mặc định (Allow / Rate-limit / Block). Dùng để ra quyết định nhanh: chặn bot phá, hạn chế bot tool, và “nuôi” bot tốt để tăng cơ hội được AI (SI - Super Intelligence) trích dẫn. Nhìn vào 1 hàng là biết: bot đó vào để làm gì, nên xử lý ở lớp nào, và cách xác thực để tránh chặn nhầm.
UA (User-Agent) là chuỗi nhận diện client/bot gửi trong HTTP header. WAF (Web Application Firewall) là lớp tường lửa ứng dụng web, chặn request xấu trước khi chạm vào WordPress/PHP.
Verified bot là bot đã được một nền tảng (thường là CDN/WAF) xác minh danh tính bằng IP validation hoặc cơ chế xác thực riêng.
Ví dụ: trong Cloudflare có danh mục “Verified Bots” và có thể lọc theo category để set rule.
5.6. Danh sách bot “nên allow” tối thiểu (nuôi bot để crawl ít mà trúng)
Bot tìm kiếm hợp lệ nên được allow để crawl/index ổn định, vì đây là “đầu vào” tạo traffic bền vững và cơ hội được AI trích dẫn. Allow không có nghĩa là thả cửa. Hãy dọn crawl trap và tối ưu đường đi (sitemap, internal link, canonical) để bot tự crawl “đúng phần”.
5.7. Danh sách bot “nên rate-limit” (hữu ích nhưng dễ tốn tài nguyên)
Nhóm SEO tools tạo giá trị cho team, nhưng nếu để crawl tự do sẽ ăn crawl budget và tải server. Rate-limit theo phút/giờ + ưu tiên cache sẽ giữ lợi ích phân tích mà không làm web ì.
5.8. SOP phân loại bot từ log (5 phút là ra quyết định)
SOP này giúp biến “một User-Agent lạ” thành quyết định rõ ràng: allow, rate-limit hay block. Không tin User-Agent một mình. Luôn nhìn thêm IP, hành vi và đường dẫn bị hit.
Output: 1 dòng nhãn cho bot (Category + Action) + 1 rule triển khai (WAF/server/robots) + 1 ghi chú kiểm tra an toàn SEO sau khi áp dụng.
6. Tối ưu để AI trích dẫn: cấu trúc Answer-first + entity + bằng chứng
AI thường trích nội dung có câu trả lời ngắn ngay dưới tiêu đề, thuật ngữ nhất quán, tiêu chí đúng/sai, bảng so sánh và checklist có output. Muốn AI trích đúng thì phải “dạy cách đọc”: nội dung rõ, có cấu trúc, có bằng chứng và có schema hỗ trợ.
Phần kỹ thuật thường giao cho lập trình viên, nhưng người ra yêu cầu phải hiểu đủ để kiểm tra lại. Khóa Học SEO Master nhắm vào phần hiểu đủ đó.
Bản đầy đủ của mục này có thêm: bảng 4 dòng (cột: Yếu tố, AI dễ trích khi, AI khó trích khi, Cách làm nhanh). Xem bản đầy đủ
Tham khảo nội bộ: AI Overview Friendly và SGE & AI Overview Tracking.
7. Dashboard theo dõi bot: từ log đến quyết định (chặn gì, sửa gì, ưu tiên gì)
Dashboard bot phải trả lời 3 câu: bot nào ăn tài nguyên, URL nào bị đập nhiều nhất, và Googlebot có còn crawl đúng trang quan trọng không. Đo để ra backlog: chặn ở lớp nào, dọn crawl trap ở đâu, tối ưu trang nào để tăng AI cite.
Bản đầy đủ của mục này có thêm: 2 bảng (tổng 7 dòng). Xem bản đầy đủ
Nền tảng nội bộ: Log File Analysis.
8. 3 tình huống thực tế (site Việt) và cách xử lý
80% case bot traffic rơi vào: brute-force WP, crawl trap từ tham số lọc/sort, và scraper copy nội dung. Mỗi case cần đúng “thuốc”: brute-force chặn ở WAF, crawl trap xử lý IA/param, scraper chặn theo hành vi + bảo toàn canonical.
9. Lỗi thường gặp khi chặn bot và cách sửa (thực chiến)
Lỗi nguy hiểm nhất là chặn nhầm Googlebot hoặc chặn nhầm đường dẫn hợp lệ; lỗi phổ biến nhất là dùng robots.txt như “công tắc ẩn index”. Mọi rule cần có log trước/sau và checklist kiểm tra để tránh “tối ưu mù”.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Lỗi, Hậu quả, Dấu hiệu, Cách sửa). Xem bản đầy đủ
10. Checklist triển khai 90 phút + checklist kiểm tra an toàn SEO
90 phút đủ để giảm phần lớn bot rác nếu làm theo thứ tự: đo log → phân loại → chặn WAF → chặn server → chỉnh robots → kiểm tra lại. Làm nhanh nhưng phải có tiêu chí đúng/sai và số trước-sau để chứng minh hiệu quả.
Làm trên website thật khác làm trên ví dụ ở chỗ sai là thấy hậu quả ngay. Đào Tạo SEO chạy trực tiếp trên website của người học.
Bản đầy đủ của mục này có thêm: bảng 6 dòng (cột: Bước, Output, Thời gian, Tiêu chí đạt), 2 danh sách (tổng 17 dòng). Xem bản đầy đủ
Checklist kiểm tra an toàn SEO:
11. Hiểu lầm và tranh luận phổ biến (để khỏi làm sai)
3 hiểu lầm phổ biến: robots.txt là cách “ẩn index”, chặn theo User-Agent là đủ, và chặn càng nhiều bot càng tốt. Vận hành đúng phải dựa vào log + hành vi. “Chặn đúng” quan trọng hơn “chặn nhiều”.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Hiểu lầm, Vì sao sai, Cách đúng, Ngoại lệ). Xem bản đầy đủ
12. Kết quả mong muốn và kinh nghiệm vận hành
Kết quả tốt là bot xấu giảm mạnh, server ổn định hơn, Googlebot crawl tập trung vào trang quan trọng, và nội dung có cấu trúc để tăng khả năng AI trích dẫn. Đừng chỉ đo “đã chặn bao nhiêu”; hãy đo “có giữ được đường crawl đúng và dữ liệu sạch không”.
Bản đầy đủ của mục này có thêm: bảng 4 dòng (cột: Chỉ số, Trước, Sau (kỳ vọng), Cách đo). Xem bản đầy đủ
Kinh nghiệm vận hành: Chặn bot “đúng” luôn đi kèm 2 việc: (1) dọn URL rác/crawl trap để Googlebot không lạc, (2) chuẩn hóa content theo Answer-first để bot tốt đọc nhanh và AI trích đúng. Chỉ chặn mà không dọn đường đi thì bot vẫn tốn quota vào phần vô nghĩa.
13. Nguồn tham khảo chính thức của Google
Các trang dưới đây là nguồn chuẩn để đối chiếu khi audit robots, crawl và verify bot. Ưu tiên Google Search Central/Crawling Infrastructure để tránh “mẹo truyền miệng”.
- Robots.txt: giới thiệu và cách Google dùng
- Robots.txt spec Google hỗ trợ
- Googlebot và cách verify
- Verify Google crawler requests
- Optimize crawl budget
- Danh sách Google crawlers (có Google-Extended)
14. FAQ về Bot Traffic (hỏi nhanh đáp gọn)
Phần này gom các câu hỏi thực chiến khi chặn bot, nuôi bot và tối ưu để AI trích dẫn. Mỗi câu trả lời đi thẳng vào cách làm và tiêu chí đúng/sai để dễ áp dụng.
Bot Traffic là gì?
Bot Traffic là tổng lượng request do bot (crawler, scraper, scanner) tạo ra thay vì người dùng thật, trong bối cảnh vận hành website và Technical SEO.
Ví dụ: GA4 không tăng user nhưng server load tăng vì bot quét /wp-login.php hoặc URL tham số lọc.
Vì sao Bot Traffic làm web chậm nhưng GA4 không tăng?
Nguyên nhân chính: bot tạo nhiều request ngắn, burst theo phút/giây và đánh vào endpoint nặng (login, search, API), khiến PHP/MySQL bận nhưng không tạo phiên người dùng hợp lệ trong GA4.
Đúng khi: log tăng request/phút, 403/429 tăng, nhưng GA4 users/sessions đứng yên.
Có nên chặn bot bằng robots.txt không?
Robots.txt phù hợp để điều phối crawl với bot tuân chuẩn (chặn đường cụt, khai sitemap), không phải lớp chặn bảo mật.
Sai khi: dùng robots.txt như cách “ẩn khỏi Google” hoặc chặn quá rộng làm mất crawl URL hợp lệ.
User-Agent có đủ để nhận diện bot không?
Không đủ. User-Agent là “nhãn” và bị giả rất dễ; cần nhìn thêm IP, rate truy cập, path, tỷ lệ lỗi (403/404/429) và pattern quét.
Đúng khi: quyết định chặn dựa trên hành vi + bằng chứng log, không dựa UA một mình.
Làm sao phân biệt Googlebot thật với bot giả?
Cách chắc nhất: xác minh bằng reverse DNS và forward DNS với IP tự xưng Googlebot hit nhiều trong log.
Sai khi: thấy UA “Googlebot” là tin ngay rồi allowlist toàn bộ.
Nên chặn bot ở lớp nào để hiệu quả nhất?
Ưu tiên: chặn càng gần “cửa” càng tốt: WAF/CDN → server (Nginx/Apache) → WordPress. Robots.txt chỉ là lớp hướng dẫn.
Đúng khi: bot xấu bị chặn trước khi vào PHP/MySQL, giảm tải rõ rệt.
Website không có Nginx/Apache thì làm sao chặn bot?
Cách làm thực tế: dùng WAF/CDN (ví dụ Cloudflare) để rate-limit/challenge theo path và hành vi; kết hợp WordPress hardening (2FA, limit login, tắt xmlrpc nếu không dùng).
Đúng khi: request vào /wp-login.php và /xmlrpc.php giảm mạnh dù không chạm server config.
“Nuôi bot” nghĩa là gì và làm sao để bot tốt crawl đúng?
“Nuôi bot” là tối ưu để bot tốt crawl ít mà trúng: sitemap chuẩn, internal link theo cụm, canonical sạch, giảm redirect vòng, dọn crawl trap do tham số.
Đúng khi: log cho thấy Googlebot hit đều sitemap và money page, thay vì sa vào URL rác.
Chặn tham số /*?* trong robots.txt có an toàn không?
Thường không an toàn nếu site có trang hợp lệ dùng query (tracking, filter hợp pháp, tìm kiếm nội bộ cần dùng). Nên chặn theo pattern cụ thể dựa trên log.
Đúng khi: chỉ chặn các tham số tạo crawl waste như replytocom, orderby, filter rác... sau khi đã thấy chúng bị bot crawl nhiều.
Tối ưu gì để nội dung dễ được AI trích dẫn?
Ưu tiên 4 thứ: 2 dòng trả lời ngay dưới mỗi H2/H3, thuật ngữ nhất quán (entity), tiêu chí “Đúng khi/Sai khi”, và bảng + checklist có output.
Đúng khi: nội dung có cấu trúc rõ, schema khớp nội dung thật và trang quan trọng được crawl/index ổn định.
Checklist kiểm tra an toàn SEO sau khi chặn bot gồm gì?
Kiểm tra tối thiểu: robots.txt 200, sitemap truy cập được, 5xx không tăng, Googlebot vẫn crawl sitemap/money page, không chặn nhầm asset/endpoint người dùng thật.
Đúng khi: bot xấu giảm, nhưng crawl của bot tìm kiếm vẫn “khỏe” và không xuất hiện spike lỗi trong GSC.
15. Lời kết
Bot Traffic không phải kẻ thù, nó là hệ sinh thái. Chặn bot xấu, dẫn bot tốt, và trình bày nội dung rõ để AI trích dẫn đúng. Khi có log + checklist + số trước-sau, quyết định kỹ thuật không còn dựa trên cảm giác mà dựa trên bằng chứng.
Bước tiếp theo
Muốn tự làm được việc này trên website của bạn?
SEO Master hướng dẫn làm SEO trong 24 buổi, từ tư duy nền tảng tới triển khai và đo lường trên website thật.
Tài liệu trả phí
Bản đầy đủ: Bot Traffic là gì - Chặn bot, nuôi bot, tối ưu AI cite
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 9.577 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 14 bước, bảng lỗi, mẫu, nghiệm thu (6 bảng)
- PDF: 26 trang, tải về
- Excel: 21 bảng và 88 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
Cách chặn bot xấu và nuôi bot tốt cho website
Các bước giúp bạn giảm bot rác làm chậm web và bẩn dữ liệu, giữ Googlebot crawl đúng trang quan trọng và tránh chặn nhầm bot tốt khi siết bảo mật.
- Đọc log tìm botLọc log Nginx hoặc Apache theo ba thứ là User-Agent, URL và IP sinh lỗi 403, 404, 429 để thấy bot nào ăn tài nguyên nhiều nhất.
- Phân loại bot theo hành viXét tần suất, đường dẫn, mã trạng thái và pattern quét của từng bot, rồi gắn nhãn Allow, Rate-limit hoặc Block, không chỉ dựa vào User-Agent.
- Xác minh Googlebot thậtKiểm tra các IP tự xưng Googlebot hit nhiều bằng reverse DNS và forward DNS, giữ IP đã verify và đưa IP giả vào danh sách block.
- Chặn bot xấu ở WAF hoặc CDNĐặt rule rate-limit trang login, chặn xmlrpc nếu không dùng và chặn file nhạy cảm ngay ở WAF hoặc CDN, trước khi request chạm vào PHP và MySQL.
- Bổ sung chặn ở server và WordPressDùng Nginx hoặc Apache chặn theo path và rate, rồi siết login, giới hạn xmlrpc và hạn chế URL rác từ search, param trong WordPress như lớp phòng thủ cuối.
- Chỉnh robots.txt để nuôi bot tốtChặn đường cụt theo pattern cụ thể lấy từ log như replytocom, orderby, add-to-cart, khai báo sitemap và không chặn quét sạch mọi tham số.
- Kiểm tra SEO sau khi chặnSo log trước và sau, xác nhận robots.txt và sitemap truy cập được, lỗi 5xx không tăng và Googlebot vẫn crawl đều sitemap cùng money page.
Câu hỏi thường gặp về Bot Traffic
Giải đáp trực tiếp các câu hỏi thường gặp về Bot Traffic dựa trên dữ liệu triển khai thực tế, quy trình kiểm thử kỹ thuật và kinh nghiệm thực chiến trên website thật để tối ưu hiệu quả tìm kiếm.
Vì sao chặn bot xong mà server vẫn chậm và tốn tài nguyên?
Thường do bot xấu bị chặn quá muộn, sau khi request đã vào PHP và MySQL, nên server vẫn trả chi phí xử lý. Chặn càng gần cửa càng hiệu quả: đặt rule ở WAF hoặc CDN trước, rồi mới tới server và WordPress. Ngoài ra cần dọn URL rác và crawl trap, nếu không bot vẫn tốn quota vào phần vô nghĩa.
Chặn nhầm Googlebot thì hậu quả là gì và làm sao tránh?
Chặn nhầm Googlebot là lỗi nguy hiểm nhất khi chặn bot, vì bot tìm kiếm mất đường crawl vào các trang có giá trị. Để tránh, bạn verify các IP tự xưng Googlebot bằng reverse DNS và forward DNS trước khi chặn, đồng thời giữ log trước và sau mỗi rule để phát hiện sớm việc Googlebot giảm crawl money page.
Làm sao biết website đang bị bot scrape copy nội dung?
Bot scrape thường tập trung vào trang có bảng hoặc FAQ, request theo nhịp đều đặn và lấy nhiều trang liên tiếp trong thời gian ngắn. Khi thấy một IP hoặc User-Agent đọc quá nhiều bài có cấu trúc theo nhịp máy chạy, bạn đưa vào danh sách scrape, đặt rule WAF challenge hoặc rate-limit và theo dõi hit theo giờ.
Chặn bot càng nhiều có giúp website an toàn và nhanh hơn không?
Không hẳn, chặn càng nhiều bot càng tốt là một hiểu lầm phổ biến. Chặn đúng quan trọng hơn chặn nhiều, vì bot tốt như Googlebot và Bingbot là đầu vào tạo traffic bền vững. Kết quả nên đo bằng việc giữ được đường crawl đúng và dữ liệu sạch, ngoài số lượng request đã chặn.
Bot tốt và bot xấu khác nhau ở những điểm nào?
Bot tốt như Googlebot, Bingbot vào để crawl, index hoặc giám sát, hành vi có mục đích và nên được allow. Bot xấu gồm scraper, scanner, brute-force thường quét rộng, burst mạnh, đánh endpoint nhạy cảm và tạo tỷ lệ lỗi cao. Nhóm SEO tools nằm giữa, hữu ích nhưng tốn tài nguyên nên cần rate-limit.
Chặn bot theo bốn lớp gồm những lớp nào và mỗi lớp làm gì?
Bốn lớp gồm WAF hoặc CDN, server, WordPress và robots.txt. WAF chặn request xấu trước khi chạm vào WordPress và PHP. Server như Nginx, Apache chặn theo path và rate. WordPress là lớp phòng thủ cuối cho login, xmlrpc và URL rác. Robots.txt chỉ là lớp hướng dẫn bot tuân chuẩn và không có tác dụng chặn bảo mật.
Triển khai chặn bot trong 90 phút đi theo thứ tự nào?
Thứ tự là đo log, phân loại bot, chặn ở WAF, chặn ở server, chỉnh robots.txt rồi kiểm tra lại. Làm đúng thứ tự đó, 90 phút đủ để giảm phần lớn bot rác. Mỗi bước cần tiêu chí đúng sai và số trước sau để chứng minh hiệu quả.
Dashboard theo dõi bot cần trả lời những câu hỏi nào?
Dashboard bot cần trả lời ba câu: bot nào đang ăn tài nguyên, URL nào bị đập nhiều nhất, và Googlebot có còn crawl đúng trang quan trọng không. Từ đó bạn ra backlog: chặn ở lớp nào, dọn crawl trap ở đâu, và tối ưu trang nào để tăng khả năng được AI trích dẫn.
Nuôi bot trong SEO khác chặn bot như thế nào?
Nuôi bot trong SEO là cho bot tốt crawl ít mà trúng, còn chặn bot là ngăn bot xấu như scraper, scanner, brute-force. Nuôi bot dùng sitemap, internal link, canonical sạch và robots.txt chặn đường cụt. Chặn bot ưu tiên WAF hoặc CDN, rồi tới server và WordPress. Hai việc đi kèm nhau khi xử lý Bot Traffic.
Website nhỏ có cần quan tâm đến Bot Traffic không?
Website nhỏ vẫn cần quan tâm đến Bot Traffic khi web chậm, log ngập bot hoặc số liệu GA4, GSC lệch. Bot rác thường đánh vào login và xmlrpc của WordPress. Site nhỏ chưa có WAF có thể chặn cơ bản bằng Apache .htaccess theo path và User-Agent, luôn test phạm vi nhỏ và có khả năng rollback.
Nên bắt đầu xử lý Bot Traffic từ đâu khi website bị chậm?
Xử lý Bot Traffic nên bắt đầu từ việc đọc log, lọc Top User-Agent, Top URL và Top IP theo lỗi 403, 404, 429. Từ đó phân loại bot theo hành vi, verify Googlebot thật bằng reverse DNS, rồi mới chặn ở WAF, server, WordPress và chỉnh robots.txt. Chặn khi chưa đọc log rất dễ chặn nhầm bot tốt.
Verified bot là gì trong Cloudflare và WAF?
Verified bot là bot đã được một nền tảng, thường là CDN hoặc WAF, xác minh danh tính bằng IP validation hoặc cơ chế xác thực riêng. Trong Cloudflare có danh mục Verified Bots và có thể lọc theo category để đặt rule. Nhận diện chỉ bằng User-Agent thì không đủ tin, vì bot xấu dễ giả User-Agent.
Làm tiếp trên chính website của bạn
Chọn theo điều bạn đang cần: người soi website, nền tảng để tự làm, hay người kèm tới nơi.
Phân tích SEO và GEO Online
Tìm đúng chỗ website đang nghẽn, bàn giao thứ tự sửa và bản đồ nội dung theo DLN™. Học tiếp Mentor thì phí này được trừ vào học phí.
Xem phạm vi phân tíchKhóa học SEO cơ bản Online
6 buổi online về Technical và On-page, đủ nền tảng để tự rà và sửa website của bạn.
Xem lộ trình họcMentor SEO 1 kèm 1 Online
12 buổi trong 4 tuần, làm trực tiếp trên website của bạn cùng Danh Nolan.
Xem cách kèm