

URL Parameters Management là cách quản lý các tham số sau dấu ? trong URL nhằm ngăn website sinh ra hàng loạt phiên bản “na ná nhau” của cùng một nội dung. Dùng khi site có lọc/sort, phân trang, UTM tracking, hoặc biến số do CMS/plugin tạo.
Lợi ích chính là giảm trùng lặp, tiết kiệm crawl budget và gom tín hiệu xếp hạng về đúng URL chuẩn.
Tài liệu trả phí
Bản đầy đủ: URL Parameters Management - Xử lý biến số bảo toàn SEO
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 6.978 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 15 bước, bảng lỗi, mẫu, nghiệm thu (5 bảng)
- PDF: 19 trang, tải về
- Excel: 25 bảng và 46 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
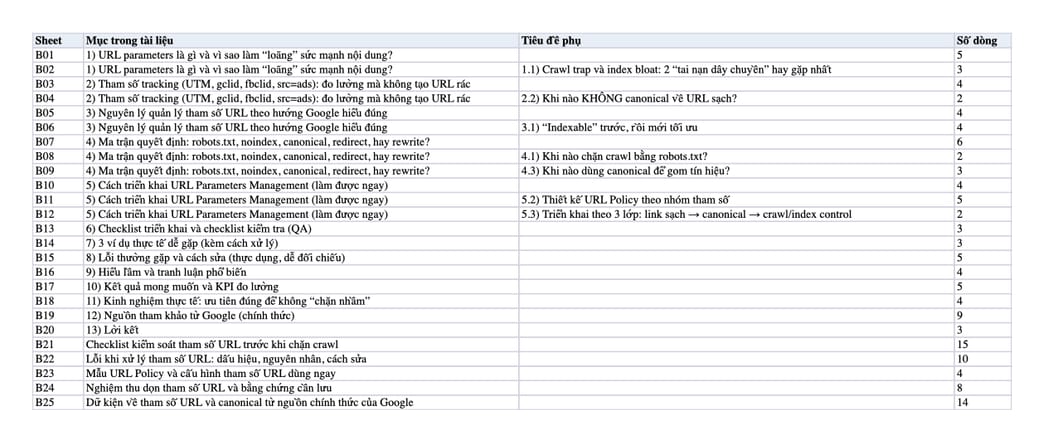
Xem trước bản đầy đủ: ba ảnh chụp từ chính tệp PDF và Excel bạn nhận sau khi mua.
1) URL parameters là gì và vì sao làm “loãng” sức mạnh nội dung?
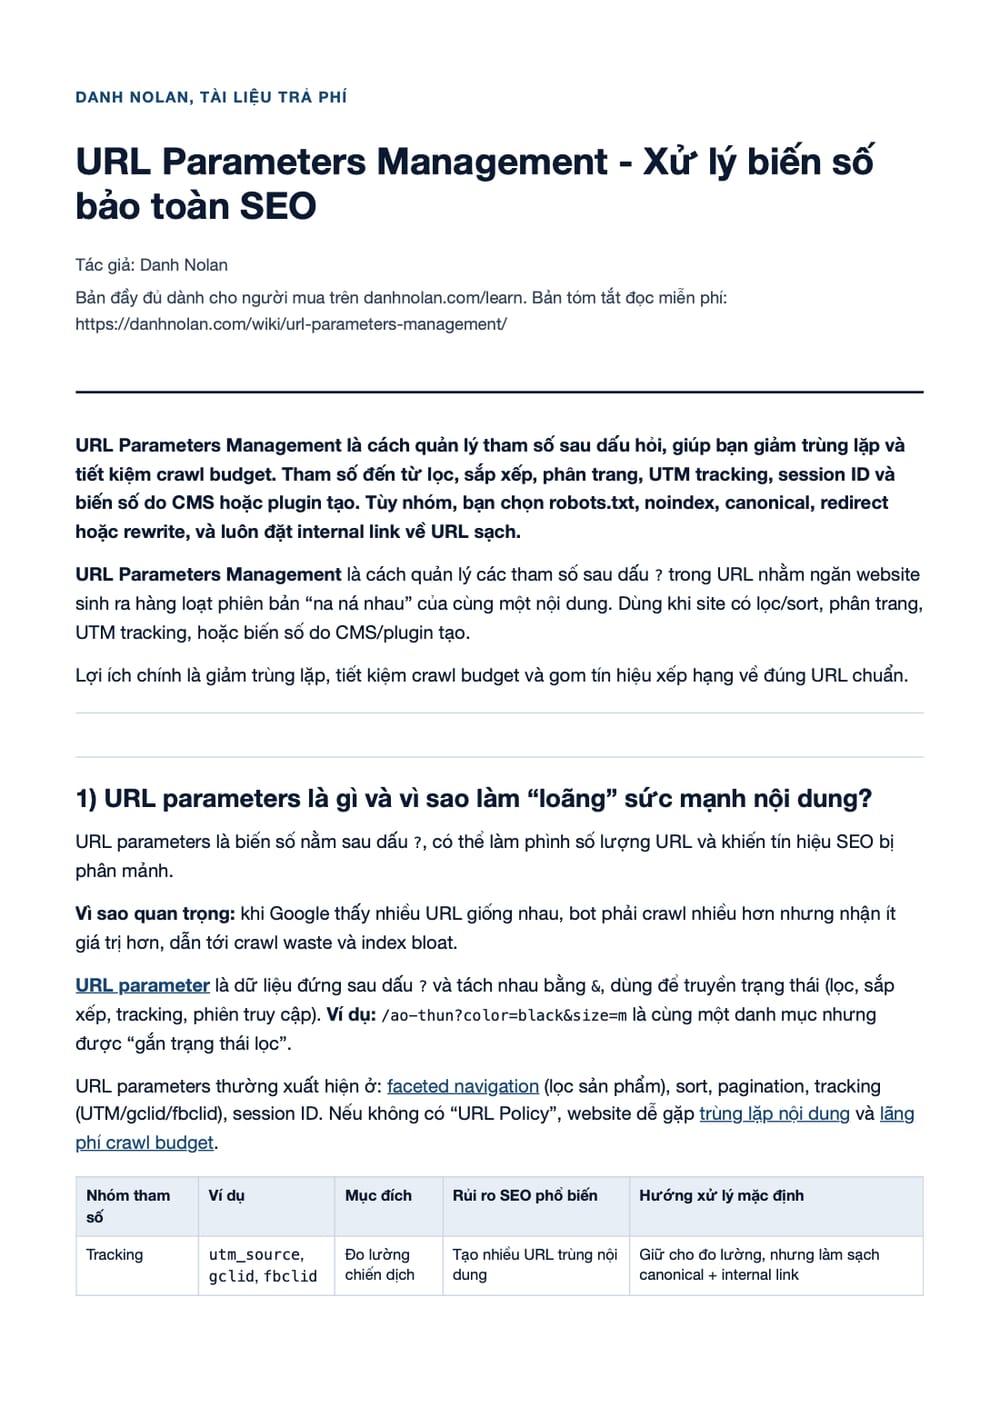
URL parameters là biến số nằm sau dấu ?, có thể làm phình số lượng URL và khiến tín hiệu SEO bị phân mảnh.
Vì sao quan trọng: khi Google thấy nhiều URL giống nhau, bot phải crawl nhiều hơn nhưng nhận ít giá trị hơn, dẫn tới crawl waste và index bloat.
URL parameter là dữ liệu đứng sau dấu ? và tách nhau bằng &, dùng để truyền trạng thái (lọc, sắp xếp, tracking, phiên truy cập). Ví dụ: /ao-thun?color=black&size=m là cùng một danh mục nhưng được “gắn trạng thái lọc”.
URL parameters thường xuất hiện ở: faceted navigation (lọc sản phẩm), sort, pagination, tracking (UTM/gclid/fbclid), session ID. Nếu không có “URL Policy”, website dễ gặp trùng lặp nội dung và lãng phí crawl budget.
Bản đầy đủ của mục này có thêm: 2 bảng (tổng 8 dòng). Xem bản đầy đủ
1.1) Crawl trap và index bloat: 2 “tai nạn dây chuyền” hay gặp nhất
Crawl trap xảy ra khi tham số tạo tổ hợp vô hạn; index bloat là khi chỉ mục phình với URL ít giá trị.
Điểm cần nhớ: bot bị kéo vào URL rác sẽ làm chậm việc phát hiện và làm mới các trang quan trọng.
Crawl trap là tình huống bot càng crawl càng sinh thêm URL mới do tổ hợp tham số. Ví dụ: bộ lọc 5 lớp tạo ra hàng chục nghìn URL mà mỗi URL chỉ thay thứ tự/điều kiện hiển thị.
Index bloat là chỉ mục chứa quá nhiều URL “mỏng”. Ví dụ: hàng loạt URL sort/view/utm bị phát hiện và được Google lưu như các trang riêng.
2) Tham số tracking (UTM, gclid, fbclid, src=ads): đo lường mà không tạo URL rác
Tham số tracking nên dùng cho đo lường từ nguồn ngoài site, nhưng không nên lan vào link nội bộ hoặc sitemap.
Đo trước khi sửa là bước hay bị bỏ qua nhất, và cũng là bước khiến mọi kết luận sau đó không kiểm chứng được. Khóa Học SEO Master đặt bước này lên đầu.
Không “cần” thêm ?src=ads vào URL bài viết trên web như một URL chuẩn; chỉ gắn ở link từ quảng cáo/email/social và luôn canonical về URL sạch.
Tracking parameter là tham số chỉ phục vụ đo lường, không tạo nội dung mới. Ví dụ: utm_source, gclid, fbclid, hoặc src tự đặt.
Nguyên tắc chung: giữ đo lường nhưng không để tracking trở thành “một phiên bản URL” trong nội bộ.
Bản đầy đủ của mục này có thêm: 2 bảng (tổng 6 dòng), danh sách 4 dòng. Xem bản đầy đủ
2.1) Có nên thêm?src=ads vào URL bài viết trên web không?
Không dùng ?src=ads làm URL chuẩn trong bài post hoặc internal link.
Cách dùng hợp lý: gắn ?src=ads ở link từ Ads để phân nguồn, rồi canonical gom tín hiệu về URL sạch.
src (ví dụ ?src=ads) là tham số tracking tự đặt để phân loại nguồn traffic theo chuẩn nội bộ. Vì src không tạo nội dung mới, mục tiêu xử lý chuẩn là không tạo trùng lặp và không làm loãng tín hiệu SEO.
2.2) Khi nào KHÔNG canonical về URL sạch?
Chỉ không canonical về URL sạch khi tham số thật sự tạo ra nội dung/intent khác và có chiến lược index riêng.
Thực tế hay gặp: nếu chỉ khác tracking hoặc khác thứ tự hiển thị, vẫn nên canonical về URL sạch.
3) Nguyên lý quản lý tham số URL theo hướng Google hiểu đúng
Mục tiêu không phải “cấm bot càng nhiều càng tốt”, mà là dẫn bot đến đúng URL đại diện cho mỗi nội dung.
Tín hiệu Google ưu tiên: canonical nhất quán, internal links sạch, sitemap chỉ chứa URL chuẩn, và kiểm soát crawl đúng chỗ.
Canonical URL là URL đại diện mà bạn muốn gom tín hiệu xếp hạng về. Ví dụ: mọi URL UTM trỏ canonical về URL sạch.
URL Policy là bộ quy tắc thống nhất tham số nào được tồn tại, tham số nào bị triệt tiêu, tham số nào được index. Ví dụ: “UTM không xuất hiện trong link nội bộ, facet SEO chỉ chọn 1-2 lớp”.
Bản đầy đủ của mục này có thêm: 2 bảng (tổng 8 dòng). Xem bản đầy đủ
Tài liệu liên quan trên website Danh Nolan: Canonicalization Strategy, Robots.txt Optimization, và Crawl Budget Management.
3.1) “Indexable” trước, rồi mới tối ưu
Một URL muốn kiểm soát index cần bot crawl được để đọc tín hiệu (noindex/canonical).
Lỗi hay gặp: disallow robots.txt rồi lại kỳ vọng noindex hoạt động, khiến kiểm soát lệch mục tiêu.
4) Ma trận quyết định: robots.txt, noindex, canonical, redirect, hay rewrite?
Chọn công cụ theo mục tiêu “index/crawl” của từng nhóm tham số sẽ ổn định và ít rủi ro hơn chặn đại.
Nguyên tắc: ưu tiên xử lý ở nguồn phát sinh (hạn chế tạo URL), sau đó mới dùng canonical/redirect và cuối cùng là robots/noindex.
Rewrite (clean URL) là đưa trạng thái quan trọng thành đường dẫn ổn định thay vì query string. Ví dụ: thay vì ?category=giay-chay-bo-nam thì dùng /giay-chay-bo-nam/ nếu đó là intent SEO.
Bản đầy đủ của mục này có thêm: 3 bảng (tổng 11 dòng), mẫu để chép. Xem bản đầy đủ
4.1) Khi nào chặn crawl bằng robots.txt?
Dùng robots.txt khi mục tiêu là tiết kiệm crawl và bạn không cần URL tham số xuất hiện trên Search.
Phù hợp nhất: pattern lọc/sort/view tạo số lượng URL rất lớn (nguy cơ crawl trap).
Xem thêm: Advanced Robots.txt Rules.
4.2) Khi nào dùng noindex (meta robots / X-Robots-Tag)?
Dùng noindex khi muốn URL không xuất hiện trên Google nhưng vẫn cho bot crawl để hiểu liên kết.
Ví dụ thực dụng: trang tìm kiếm nội bộ, trang lọc tạm thời, trang cảm ơn, trang login.
Tài liệu nền: Indexifembedded & Noindex.
4.3) Khi nào dùng canonical để gom tín hiệu?
Dùng canonical khi có nhiều URL “rất giống nhau” và cần một URL đại diện để gom tín hiệu xếp hạng.
Điều kiện để canonical mạnh: internal links trỏ URL chuẩn, sitemap chỉ chứa URL chuẩn, và không xung đột với redirect/noindex.
Liên quan: Canonicalization Strategy và Cannibalization Audit (phần hợp nhất tín hiệu).
5) Cách triển khai URL Parameters Management (làm được ngay)
Triển khai hiệu quả cần đủ 5 đầu ra: audit tham số, phân loại giá trị, rule set kỹ thuật, checklist QA, và monitoring.
Đầu ra quan trọng nhất: “URL Policy” giúp dev, SEO, content cùng một luật chơi và giảm tái phát URL rác.
Đầu ra cần có: (1) danh sách tham số đang tồn tại, (2) phân loại “có giá trị SEO” vs “chỉ phục vụ UX/Tracking”, (3) bộ rule robots/noindex/canonical/redirect, (4) checklist QA và (5) dashboard theo dõi index/crawl. Khi đủ 5 đầu ra này, việc kiểm soát URL rác ổn định theo hệ thống, không phụ thuộc “vá lỗi” từng URL.
Bản đầy đủ của mục này có thêm: 3 bảng (tổng 11 dòng), 2 danh sách (tổng 8 dòng). Xem bản đầy đủ
5.1) Audit: tìm đúng “nguồn phát sinh” URL tham số
Audit tốt là tìm ra 1-2 pattern tạo 80% URL rác để xử lý trước (quy tắc 20/80).
Ưu tiên: kiểm tra internal links, bộ lọc/sort, plugin tracking, search nội bộ, và template pagination.
5.2) Thiết kế URL Policy theo nhóm tham số
URL Policy giúp thống nhất “được phép tồn tại” và “được phép index”, tránh mỗi người làm một kiểu gây rác.
Output mong muốn: bảng whitelist + rule canonical + rule crawl/index theo từng nhóm tham số.
Nếu website chạy WordPress/WooCommerce và hay phát sinh biến thể mỏng, xem thêm: WordPress hay bị thin content.
5.3) Triển khai theo 3 lớp: link sạch → canonical → crawl/index control
Làm đúng thứ tự giúp giảm rủi ro và bền hơn: link sạch (ngăn nguồn) rồi mới canonical (gom tín hiệu), cuối cùng mới robots/noindex (điều phối crawl/index).
Output cần đạt: giảm URL có ? trong internal links, canonical khớp hơn, và crawl tập trung vào URL quan trọng.
5.3.1) Làm sạch internal links (làm trước tiên)
Nếu internal links liên tục sinh URL có ?, mọi biện pháp phía sau sẽ tốn công mà không bền. Mục tiêu là link nội bộ chỉ trỏ URL chuẩn; tham số chỉ phục vụ UX hoặc đo lường từ nguồn ngoài.
5.3.2) Pagination và infinite scroll đúng mục tiêu
Pagination đúng giúp bot khám phá nội dung sâu trong danh mục mà không tạo trùng lặp vô nghĩa. Điểm mấu chốt: mỗi trang phân trang là một URL riêng và canonical nên self-canonical (không gom hết về trang 1).
Trang liên quan: Pagination & Infinite Scroll Engineering.
6) Checklist triển khai và checklist kiểm tra (QA)
Checklist triển khai và checklist kiểm tra (QA) cho tham số URL giúp làm theo pattern, tránh chặn nhầm URL có giá trị. Nguyên tắc là pilot 1-2 pattern, đo lại crawl và index rồi mới mở rộng. Triển khai gồm URL Policy, làm sạch internal links, canonical, robots.txt, noindex. QA kiểm URL quan trọng trả 200 OK.
Checklist giúp triển khai theo pattern và tránh chặn nhầm URL có giá trị.
Làm trên website thật khác làm trên ví dụ ở chỗ sai là thấy hậu quả ngay. Đào Tạo SEO chạy trực tiếp trên website của người học.
Nguyên tắc vận hành: pilot 1-2 pattern, đo lại crawl/index, rồi mới mở rộng rule set.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Checklist, Mục tiêu, Ai phụ trách, Tần suất), danh sách 15 dòng. Xem bản đầy đủ
7) 3 ví dụ thực tế dễ gặp (kèm cách xử lý)
3 case dưới đây bao phủ phần lớn thực tế: faceted ecommerce, tracking UTM khi share, và CMS/plugin sinh URL mỏng.
Cách đọc ví dụ: xác định nhóm tham số → chọn công cụ theo ma trận → đặt KPI để biết đã “sạch” hay chưa.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Ví dụ, Nhóm tham số, Rủi ro chính, Giải pháp khuyến nghị), danh sách 4 dòng. Xem bản đầy đủ
7.1) Ecommerce: /category?color=red&size=m&sort=price_asc
Đây là tổ hợp dễ tạo hàng nghìn URL từ một danh mục; đa số không có nhu cầu tìm kiếm riêng.
Cách xử lý an toàn: tách facet SEO (có nhu cầu) và facet UX (không nhu cầu), rồi chặn tổ hợp sâu + sort.
7.2) Blog: /bai-viet?utm_source=facebook&utm_campaign=tet
UTM cần cho đo lường, nhưng không nên trở thành URL nội bộ hoặc URL trong sitemap.
Cách làm chuẩn: canonical về URL sạch và bảo đảm internal links không chứa UTM.
Tài liệu liên quan: Traffic là gì (phần đo lường và UTM).
7.3) WordPress: /?s=keyword&orderby=... hoặc filter do plugin
WordPress/plugin dễ sinh URL mỏng từ search nội bộ, tag/author, filter/sort và attachment.
Cách làm bền: chặn nguồn phát sinh, chuẩn hóa canonical và kiểm soát index/noindex theo nhóm trang.
Tham khảo: WordPress hay bị thin content.
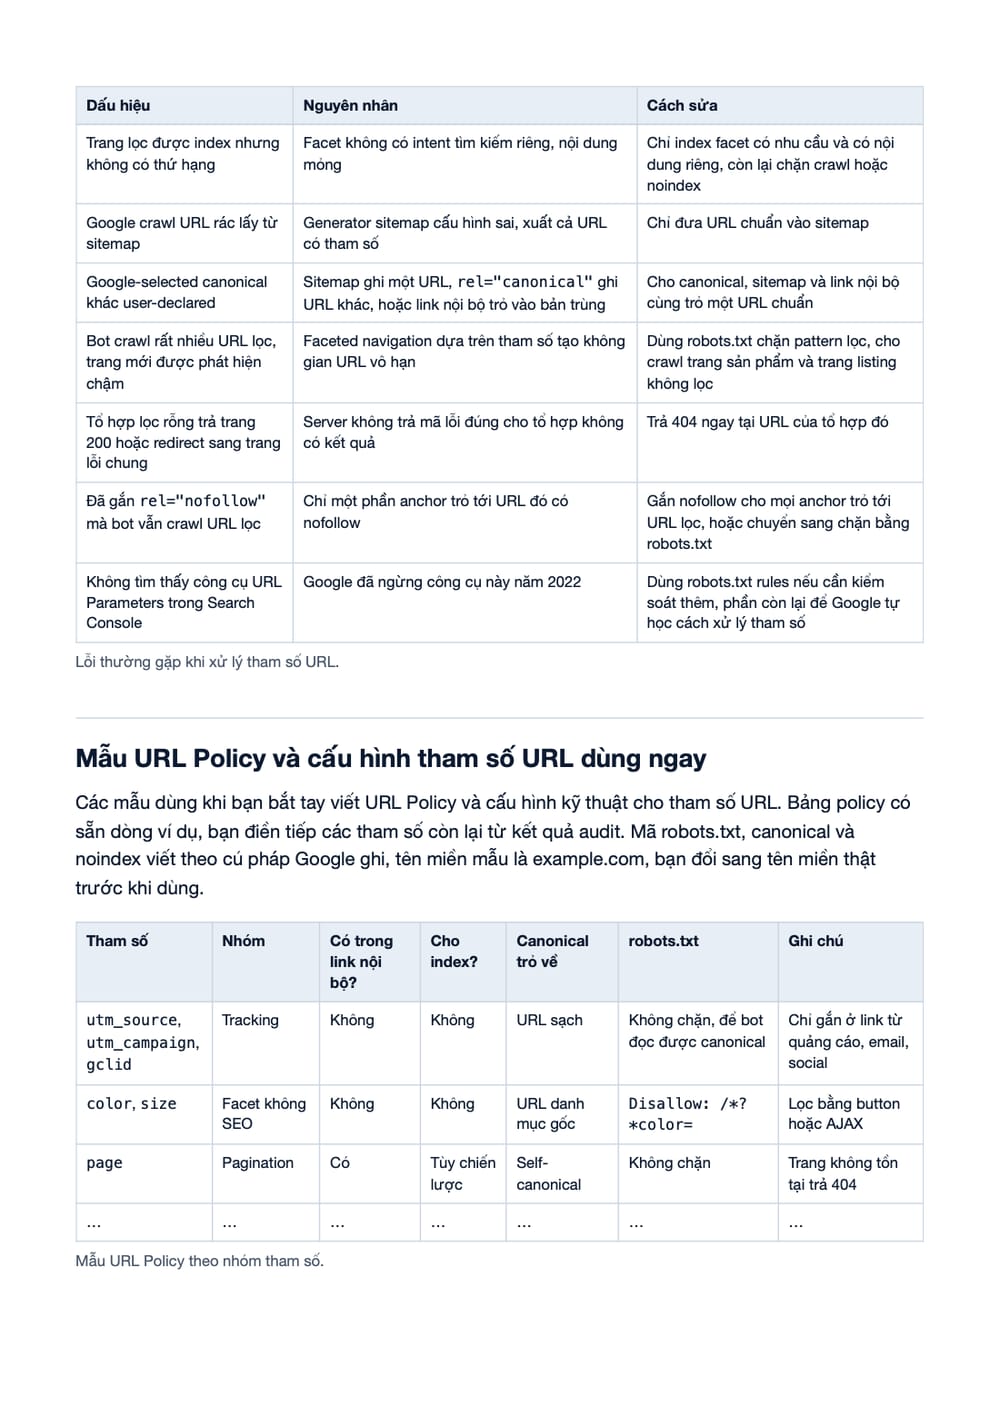
8) Lỗi thường gặp và cách sửa (thực dụng, dễ đối chiếu)
Lỗi thường gặp nhất với URL tham số là dùng sai công cụ hoặc để robots, noindex, canonical và redirect xung đột nhau. Ví dụ, Disallow khiến bot không đọc được noindex, còn canonical mọi phân trang về trang 1 khiến trang sâu không được khám phá. Cách sửa là chọn một hướng rõ, chỉ đưa URL chuẩn vào sitemap.
Lỗi phổ biến nhất là dùng sai công cụ hoặc để xung đột giữa robots/noindex/canonical/redirect.
Cách dùng bảng: nhìn dấu hiệu → khoanh vùng nguyên nhân → sửa đúng hướng để tránh tái phát.
Bản đầy đủ của mục này có thêm: bảng 5 dòng (cột: Lỗi, Dấu hiệu, Nguyên nhân gốc, Cách sửa). Xem bản đầy đủ
9) Hiểu lầm và tranh luận phổ biến
Phần lớn tranh luận đến từ việc đánh đồng “crawl” với “index”, hoặc xem canonical như mệnh lệnh tuyệt đối.
Nguyên tắc chung: mỗi công cụ có mục tiêu riêng; dùng đúng mục tiêu thì site vừa sạch vừa không mất traffic.
Bản đầy đủ của mục này có thêm: bảng 4 dòng (cột: Hiểu lầm, Thực tế, Cách làm đúng). Xem bản đầy đủ
10) Kết quả mong muốn và KPI đo lường
URL Parameters Management thành công khi bot tập trung crawl đúng trang và chỉ mục “gọn” nhưng chất lượng hơn.
Cách đo chuẩn: đo KPI crawl/index/canonical và theo dõi tác động lên traffic, lead, doanh thu.
Bản đầy đủ của mục này có thêm: bảng 5 dòng (cột: KPI, Đo bằng gì, Xu hướng mong muốn, Ý nghĩa). Xem bản đầy đủ
11) Kinh nghiệm thực tế: ưu tiên đúng để không “chặn nhầm”
Sai lầm phổ biến là “chặn trước rồi mới hiểu”, dẫn đến mất index trang tốt hoặc phá luồng khám phá.
Trình tự ít rủi ro: link sạch → policy rõ → pilot theo pattern → đo lại → mở rộng rule set.
Bản đầy đủ của mục này có thêm: bảng 4 dòng (cột: Ưu tiên, Lý do, Gợi ý áp dụng). Xem bản đầy đủ
12) Nguồn tham khảo từ Google (chính thức)
Các tài liệu Google dưới đây là nền tảng để thiết kế URL Policy và chọn công cụ đúng mục tiêu.
Gợi ý đọc: nếu site lớn (đặc biệt ecommerce), ưu tiên faceted navigation và pagination trước khi “đụng robots/noindex”.
| Chủ đề | Tài liệu Google | Dùng khi |
|---|---|---|
| Faceted navigation | Managing crawling of faceted navigation URLs | Có bộ lọc/sort tạo nhiều URL |
| URL structure | URL Structure Best Practices | Thiết kế URL sạch, nhất quán |
| robots.txt | Robots.txt Introduction and Guide | Chặn crawl theo pattern |
| Canonical | Consolidate duplicate URLs | Gom tín hiệu URL trùng |
| Noindex | Block Search Indexing with noindex | Chặn index nhưng vẫn cho crawl |
| Robots meta tag | Robots meta tag specifications | Triển khai noindex đúng chuẩn |
| Pagination | Pagination & incremental page loading | Phân trang & “load more” |
| Special tags | Meta tags and attributes Google supports | Kiểm tra tag hỗ trợ |
| Search Console | URL Parameters tool deprecated | Biết công cụ tham số đã ngừng |
13) Lời kết
Quản lý tham số URL là bài toán “giữ tín hiệu về đúng nơi”, không phải bài toán “chặn cho sạch”.
Thực hành bền: làm sạch internal links, đặt URL Policy, pilot theo pattern, rồi mới khóa crawl/index và theo dõi KPI.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Trước khi làm, Sau khi làm đúng, Ý nghĩa SEO). Xem bản đầy đủ
Nếu đang thấy dấu hiệu “bài tốt bị kéo tụt bởi URL rác”, nên dọn theo cụm: tham số → canonical → robots/noindex → sitemap → QA. Bài liên quan: Crawl Budget Management và WordPress hay bị thin content.
Bước tiếp theo
Muốn tự làm được việc này trên website của bạn?
SEO Master hướng dẫn làm SEO trong 24 buổi, từ tư duy nền tảng tới triển khai và đo lường trên website thật.
Tài liệu trả phí
Bản đầy đủ: URL Parameters Management - Xử lý biến số bảo toàn SEO
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 6.978 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 15 bước, bảng lỗi, mẫu, nghiệm thu (5 bảng)
- PDF: 19 trang, tải về
- Excel: 25 bảng và 46 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
Cách quản lý tham số URL để giảm trùng lặp
Các bước giúp bạn gom tín hiệu xếp hạng về URL chuẩn, giảm trùng lặp, tiết kiệm crawl budget và tránh chặn nhầm URL có giá trị khi xử lý tham số.
- Rà nguồn phát sinh tham sốKiểm tra internal links, bộ lọc và sort, plugin tracking, search nội bộ và template pagination để tìm pattern tạo phần lớn URL rác.
- Phân loại tham số theo giá trịTách tham số có giá trị SEO khỏi tham số chỉ phục vụ UX hoặc tracking, rồi ghi thành URL Policy gồm whitelist, rule canonical và rule crawl, index theo từng nhóm.
- Làm sạch internal links trước tiênCho link nội bộ chỉ trỏ về URL chuẩn, không chứa UTM hay tham số lọc, để chặn nguồn sinh URL rác trước khi dùng công cụ khác.
- Đặt canonical về URL đại diệnTrỏ canonical các URL tracking, sort về URL sạch, giữ self-canonical cho từng trang phân trang, và chỉ đưa URL chuẩn vào sitemap.
- Điều phối crawl và indexDùng robots.txt cho pattern lọc, sort, view tạo quá nhiều URL, dùng noindex cho trang tìm kiếm nội bộ, trang cảm ơn, trang login mà bot vẫn cần crawl.
- Chạy thử rồi mở rộng rule setPilot trên 1-2 pattern, đo lại crawl, index và kiểm URL quan trọng trả 200 OK, sau đó mới mở rộng rule set và theo dõi KPI.
Câu hỏi thường gặp về URL Parameters Management
Giải đáp trực tiếp các câu hỏi thường gặp về URL Parameters Management dựa trên dữ liệu triển khai thực tế, quy trình kiểm thử kỹ thuật và kinh nghiệm thực chiến trên website thật để tối ưu hiệu quả tìm kiếm.
Vì sao chặn robots.txt rồi mà thẻ noindex trên URL tham số không có tác dụng?
Vì Disallow khiến bot không crawl được URL nên không đọc được noindex. Một URL muốn kiểm soát index cần bot crawl được để đọc tín hiệu noindex hoặc canonical. Bạn chọn một hướng rõ: cần URL rời khỏi chỉ mục thì để bot crawl và đặt noindex, cần tiết kiệm crawl thì mới chặn bằng robots.txt.
Canonical mọi trang phân trang về trang 1 gây ra vấn đề gì?
Canonical mọi trang phân trang về trang 1 khiến các trang sâu trong danh mục không được khám phá. Mỗi trang phân trang là một URL riêng và nên self-canonical. Pagination đúng giúp bot đi tới nội dung sâu mà không tạo trùng lặp vô nghĩa.
Vì sao đã xử lý từng URL rác mà URL tham số mới vẫn tiếp tục phát sinh?
Thường do nguồn phát sinh vẫn còn, nhất là internal links liên tục sinh URL có tham số. Khi đó mọi biện pháp phía sau tốn công mà không bền. Bạn làm sạch link nội bộ trước, rồi đặt URL Policy để dev, SEO, content cùng một luật chơi và giảm tái phát URL rác.
Chặn tham số URL quá tay có thể làm website mất gì?
Chặn quá tay có thể làm mất index trang tốt hoặc phá luồng khám phá của bot. Sai lầm phổ biến là chặn trước rồi mới hiểu. Trình tự ít rủi ro là làm sạch link, đặt policy rõ, pilot theo pattern, đo lại rồi mới mở rộng rule set.
Crawl trap và index bloat khác nhau như thế nào?
Crawl trap là khi bot càng crawl càng sinh thêm URL mới do tổ hợp tham số tạo vô hạn. Index bloat là khi chỉ mục chứa quá nhiều URL mỏng, ví dụ URL sort, view, utm được lưu như trang riêng. Cả hai làm chậm việc phát hiện và làm mới trang quan trọng.
Triển khai quản lý tham số URL cần những đầu ra nào?
Triển khai cần đủ 5 đầu ra: danh sách tham số đang tồn tại, phân loại có giá trị SEO hay chỉ phục vụ UX và tracking, bộ rule robots, noindex, canonical, redirect, checklist QA và dashboard theo dõi index, crawl. Đầu ra quan trọng nhất là URL Policy.
Rewrite URL tham số thành clean URL nên dùng trong trường hợp nào?
Rewrite phù hợp khi trạng thái trong tham số là intent SEO có nhu cầu tìm kiếm riêng. Rewrite đưa trạng thái quan trọng thành đường dẫn ổn định trong URL, không để ở query string. Facet chỉ phục vụ UX thì giữ dạng tham số và kiểm soát bằng canonical hoặc chặn tổ hợp sâu.
Đo hiệu quả quản lý tham số URL bằng những KPI nào?
Bạn đo KPI crawl, index và canonical, rồi theo dõi tác động lên traffic, lead và doanh thu. Quản lý tham số thành công khi bot tập trung crawl đúng trang, chỉ mục gọn nhưng chất lượng hơn, canonical khớp hơn và số URL tham số trong internal links giảm.
URL Parameters Management là gì và website nào cần làm?
URL Parameters Management là cách quản lý tham số sau dấu hỏi trong URL để website không sinh hàng loạt phiên bản na ná nhau của cùng một nội dung. Website có lọc, sort, phân trang, UTM tracking hoặc biến số do CMS, plugin tạo đều cần URL Parameters Management để giảm trùng lặp và tiết kiệm crawl budget.
Noindex và robots.txt khác nhau thế nào khi xử lý URL tham số?
Robots.txt chặn crawl, còn noindex chặn index nhưng vẫn cho bot crawl. Khi xử lý URL tham số, robots.txt hợp với pattern lọc, sort, view tạo số lượng URL rất lớn mà bạn không cần trên Search. Noindex hợp với trang tìm kiếm nội bộ, trang login, trang cảm ơn cần ẩn khỏi Google.
Nên bắt đầu quản lý tham số URL từ đâu?
Quản lý tham số URL nên bắt đầu từ audit nguồn phát sinh, tìm 1-2 pattern tạo 80% URL rác để xử lý trước. Sau đó làm sạch internal links, đặt URL Policy theo nhóm tham số, rồi mới canonical và kiểm soát crawl, index bằng robots.txt hoặc noindex.
Công cụ URL Parameters trong Search Console còn dùng được để xử lý tham số không?
Công cụ URL Parameters trong Search Console đã ngừng hoạt động. Để Google hiểu đúng URL tham số, bạn dựa vào canonical nhất quán, internal links sạch, sitemap chỉ chứa URL chuẩn và kiểm soát crawl đúng chỗ bằng robots.txt hoặc noindex. Các tín hiệu này nằm ngay trên website.
Làm tiếp trên chính website của bạn
Chọn theo điều bạn đang cần: người soi website, nền tảng để tự làm, hay người kèm tới nơi.
Phân tích SEO và GEO Online
Tìm đúng chỗ website đang nghẽn, bàn giao thứ tự sửa và bản đồ nội dung theo DLN™. Học tiếp Mentor thì phí này được trừ vào học phí.
Xem phạm vi phân tíchKhóa học SEO cơ bản Online
6 buổi online về Technical và On-page, đủ nền tảng để tự rà và sửa website của bạn.
Xem lộ trình họcMentor SEO 1 kèm 1 Online
12 buổi trong 4 tuần, làm trực tiếp trên website của bạn cùng Danh Nolan.
Xem cách kèm