

Google Search là một hệ thống phân tán phức tạp với mục tiêu sắp xếp thông tin thế giới và làm cho thông tin đó trở nên hữu ích, có thể truy cập được trên toàn cầu. Để hiển thị một kết quả tìm kiếm, Google phải trải qua quy trình ba giai đoạn chính: Thu thập dữ liệu (Crawling), Lập chỉ mục (Indexing) và Phục vụ kết quả (Serving). Hiểu rõ cách Google "nhìn" website là nền tảng cốt lõi của SEO kỹ thuật.
Tài liệu trả phí
Bản đầy đủ: How Google Search Works - Crawling, Indexing & Serving
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 4.649 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 12 bước, bảng lỗi, mẫu, nghiệm thu (5 bảng)
- PDF: 8 trang, tải về
- Excel: 6 bảng và 46 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
299.000đ thanh toán 12 USD qua PayPal hoặc thẻ Visa, Mastercard
Xem trước bản đầy đủ: ba ảnh chụp từ chính tệp PDF và Excel bạn nhận sau khi mua.
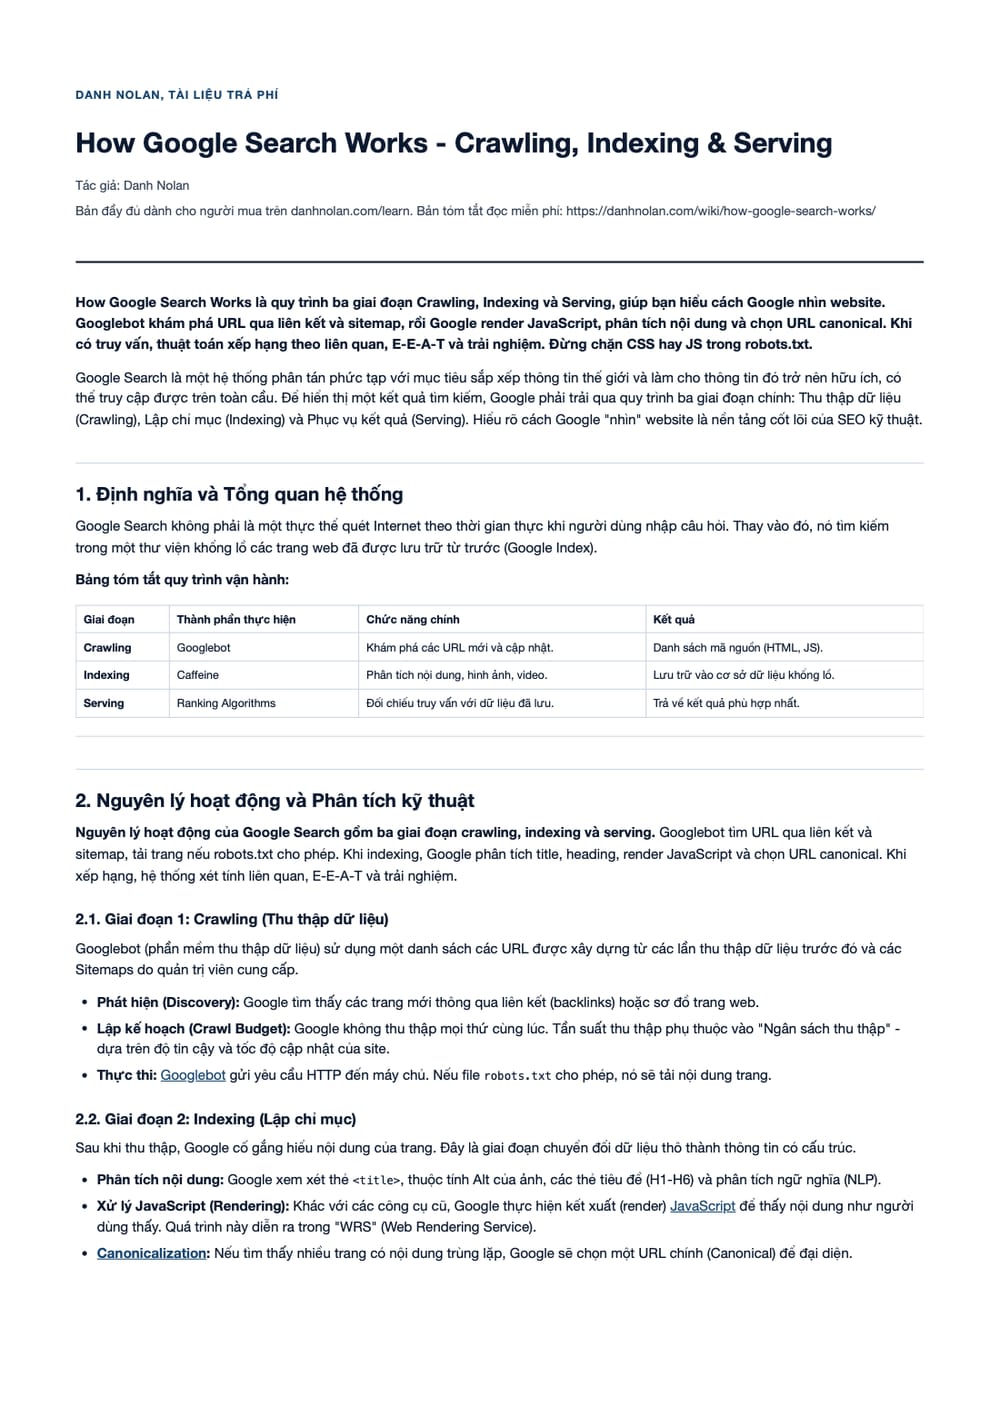
1. Định nghĩa và Tổng quan hệ thống
Google Search không phải là một thực thể quét Internet theo thời gian thực khi người dùng nhập câu hỏi. Thay vào đó, nó tìm kiếm trong một thư viện khổng lồ các trang web đã được lưu trữ từ trước (Google Index).
Bảng tóm tắt quy trình vận hành:
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Giai đoạn, Thành phần thực hiện, Chức năng chính, Kết quả). Xem bản đầy đủ
2. Nguyên lý hoạt động và Phân tích kỹ thuật
Nguyên lý hoạt động của Google Search gồm ba giai đoạn crawling, indexing và serving. Googlebot tìm URL qua liên kết và sitemap, tải trang nếu robots.txt cho phép. Khi indexing, Google phân tích title, heading, render JavaScript và chọn URL canonical. Khi xếp hạng, hệ thống xét tính liên quan, E-E-A-T và trải nghiệm.
2.1. Giai đoạn 1: Crawling (Thu thập dữ liệu)
Googlebot (phần mềm thu thập dữ liệu) sử dụng một danh sách các URL được xây dựng từ các lần thu thập dữ liệu trước đó và các Sitemaps do quản trị viên cung cấp.
Bản đầy đủ của mục này có thêm: 3 danh sách (tổng 9 dòng). Xem bản đầy đủ
2.2. Giai đoạn 2: Indexing (Lập chỉ mục)
Sau khi thu thập, Google cố gắng hiểu nội dung của trang. Đây là giai đoạn chuyển đổi dữ liệu thô thành thông tin có cấu trúc.
2.3. Giai đoạn 3: Serving & Ranking (Phục vụ và Xếp hạng)
Khi người dùng tìm kiếm, thuật toán sẽ lọc qua hàng tỷ trang trong Index để trả về kết quả trong chưa đầy 1 giây.
3. Cách Google "nhìn" Website: Cơ bản đến Nâng cao
Cách Google "nhìn" Website chủ yếu dựa vào văn bản và DOM sau khi render. Google không xem ảnh hay video mà đọc metadata đính kèm. Googlebot dùng Chrome bản mới nhất, nên DOM sau khi chạy JavaScript mới là thứ được đánh giá. Nội dung sau biểu mẫu đăng nhập hoặc paywall thường không được thu thập.
Để một website được Google ưu tiên, cần tuân thủ quy trình triển khai sau:
Phần nền vững hay không sẽ lộ ra khi bạn bắt tay vào website thật. Khóa Học SEO ghi rõ mỗi chương trình cần sẵn những gì trước khi vào học.
3.1. Chế độ xem văn bản (Text-only view)
Mặc dù Google đã thông minh hơn, nhưng "mắt" của nó vẫn chủ yếu dựa vào văn bản. Google không "xem" ảnh hay video như con người mà đọc các siêu dữ liệu (metadata) đính kèm.
3.2. Cấu trúc Render (DOM)
Googlebot hiện nay sử dụng trình duyệt Chrome phiên bản mới nhất (Evergreen Googlebot) để thực hiện render trang. Điều này có nghĩa là cấu trúc DOM sau khi chạy JavaScript mới là thứ Google thực sự đánh giá, thay vì chỉ là mã nguồn HTML thô (View Source).
3.3. Ngoại lệ và Hạn chế
Có hai loại nội dung Google không lấy được. Trang nằm sau biểu mẫu đăng nhập hoặc tường phí thì bot không vào được trừ khi có khai báo đặc biệt; còn các định dạng đã ngừng hỗ trợ thì không được lập chỉ mục nội dung. Nội dung hay nằm sau tường đăng nhập xem như không tồn tại.
Bản đầy đủ của mục này có thêm: danh sách 2 dòng. Xem bản đầy đủ
4. Quy trình triển khai tối ưu hóa cho Google Search
Quy trình triển khai tối ưu hóa cho Google Search gồm năm bước. Xác minh website qua Google Search Console, cấu hình robots.txt chặn thư mục không cần thiết, gửi sitemap.xml để rút ngắn giai đoạn Discovery, dùng Schema.org để Google hiểu thực thể, và giữ CSS/JS không bị chặn cùng TTFB nhanh.
Danh sách việc cần tối ưu luôn dài hơn thời gian có. Khóa Học SEO Master xếp thứ tự theo mức ảnh hưởng thay vì theo mức dễ làm.
Bản đầy đủ của mục này có thêm: danh sách 5 dòng. Xem bản đầy đủ
5. Checklists và Kiểm soát chất lượng
Checklists và kiểm soát chất lượng gồm hai phần. Khi triển khai, xác minh Google Search Console, không chặn CSS và JS, giữ sitemap không có URL lỗi 404 và cấu hình canonical. Khi audit, xem bản render trong công cụ Kiểm tra URL, kiểm lỗi crawl hàng tuần và thẻ noindex trên trang quan trọng.
5.1. Checklist triển khai (SEO Implementation)
Năm việc trong checklist triển khai đều là phần nền của một website được thu thập tốt. Cài và xác minh Search Console, để robots.txt không chặn tài nguyên quan trọng như CSS và JS, giữ sitemap tự cập nhật và không chứa URL lỗi, cấu hình thẻ canonical, và giữ cấu trúc URL phân cấp rõ. Chặn nhầm CSS là lỗi hay gặp nhất.
Bản đầy đủ của mục này có thêm: 2 danh sách (tổng 9 dòng). Xem bản đầy đủ
5.2. Checklist kiểm tra (Audit)
Bốn việc kiểm đều nhìn vào bản mà Google thật sự thấy, không phải bản bạn thấy. Dùng công cụ kiểm tra URL để xem bản dựng ra, bảo đảm nội dung quan trọng nằm trong HTML hoặc dựng thành công, kiểm lỗi thu thập hàng tuần, và bảo đảm trang quan trọng không dính thẻ chặn lập chỉ mục.
6. Lỗi thường gặp và Hiểu lầm phổ biến
Lỗi thường gặp và hiểu lầm phổ biến về Google Search gồm chặn CSS và JS, liên kết nội bộ quá sâu và nội dung mỏng. Hiểu lầm là nghĩ Google thấy bài ngay, đọc được mọi thứ trong ảnh, hoặc đăng nhiều thì crawl budget lớn hơn. Thực tế, chất lượng domain mới là yếu tố quyết định.
6.1. Lỗi thường gặp
Ba lỗi phổ biến đều chặn bot ở ba chỗ khác nhau. Chặn tài nguyên dựng trang khiến Google không hiểu được giao diện di động, cấu trúc liên kết quá sâu khiến bot bỏ cuộc trước khi tới nơi, còn nội dung mỏng thì vào tới nơi cũng không đủ lý do để giữ lại. Lỗi đầu là lỗi vô tình nhiều nhất.
Bản đầy đủ của mục này có thêm: 2 danh sách (tổng 6 dòng). Xem bản đầy đủ
6.2. Hiểu lầm phổ biến
Ba hiểu lầm đều đến từ việc hình dung sai tốc độ và khả năng của bot. Đăng bài xong Google không thấy ngay mà có thể mất vài ngày tới vài tuần; Google không đọc được nội dung trong ảnh nên cần thuộc tính mô tả; và đăng nhiều không tự động làm bot vào thường xuyên hơn.
7. Ví dụ thực tế và Kết quả triển khai
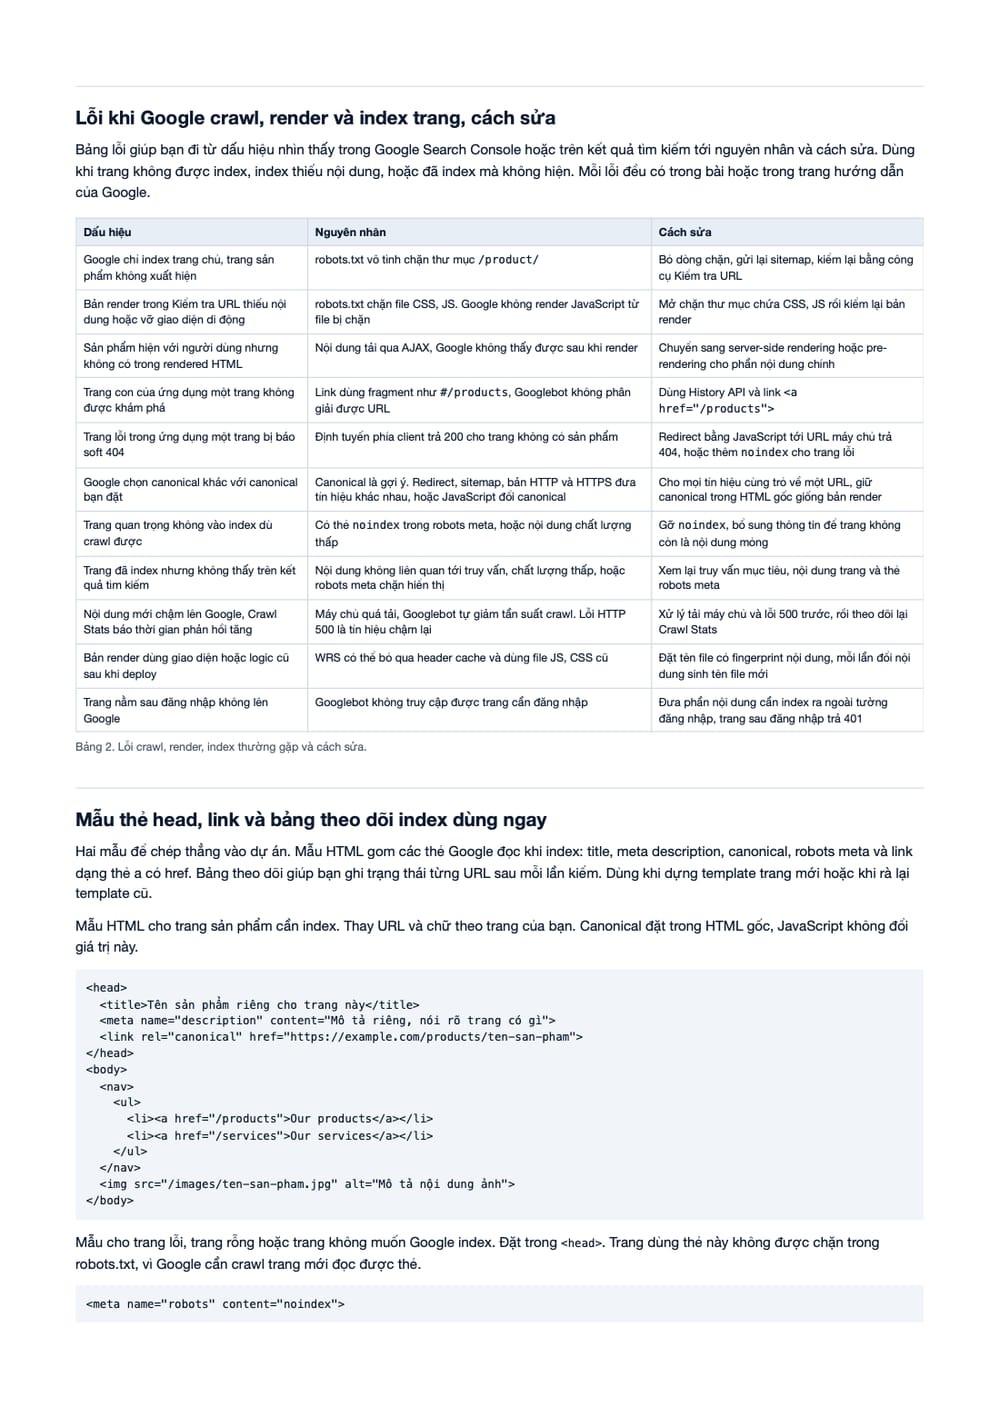
Ví dụ thực tế về Google Search là một website thương mại điện tử mới chỉ được index trang chủ. Nguyên nhân là robots.txt chặn thư mục /product/ và sản phẩm tải qua AJAX chưa được tối ưu để render. Sau khi mở chặn và dùng SSR, số trang được index tăng 500% trong 2 tuần.
Ví dụ: Một website thương mại điện tử mới ra mắt.
Bản đầy đủ của mục này có thêm: danh sách 3 dòng. Xem bản đầy đủ
8. Kinh nghiệm thực tế (Expert Insights)
Trong quá trình làm SEO, việc theo dõi báo cáo "Crawl Stats" (Số liệu thống kê thu thập dữ liệu) trong GSC là quan trọng nhất. Nếu biểu đồ thời gian phản hồi tăng cao, đó là dấu hiệu máy chủ của bạn đang quá tải, Googlebot sẽ tự động giảm tần suất thu thập, dẫn đến việc nội dung mới chậm được hiển thị trên kết quả tìm kiếm.
Lời kết
Sự vận hành của Google Search là một chuỗi quy trình logic và khắt khe. Việc hiểu rõ cách hệ thống Thu thập dữ liệu, Lập chỉ mục và Xếp hạng không chỉ giúp các nhà quản trị web tối ưu hóa kỹ thuật hiệu quả mà còn xây dựng được chiến lược nội dung bền vững, thân thiện với "mắt thần" của Google.
Bước tiếp theo
Muốn tự làm được việc này trên website của bạn?
SEO Master hướng dẫn làm SEO trong 24 buổi, từ tư duy nền tảng tới triển khai và đo lường trên website thật.
Tài liệu trả phí
Bản đầy đủ: How Google Search Works - Crawling, Indexing & Serving
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 4.649 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 12 bước, bảng lỗi, mẫu, nghiệm thu (5 bảng)
- PDF: 8 trang, tải về
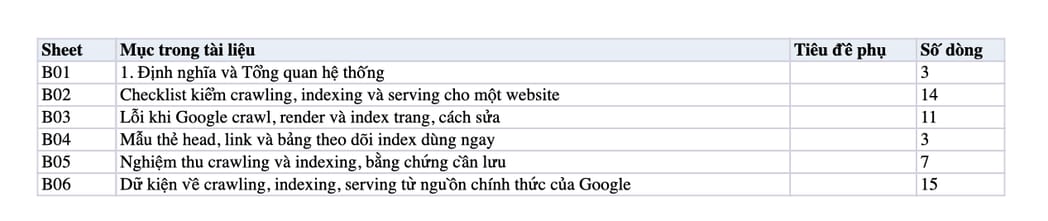
- Excel: 6 bảng và 46 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
299.000đ thanh toán 12 USD qua PayPal hoặc thẻ Visa, Mastercard
Cách tối ưu website để Google thu thập và lập chỉ mục đúng
Các bước giúp Googlebot tìm thấy URL, tải được tài nguyên dựng trang và hiểu đúng nội dung, để trang quan trọng được lập chỉ mục và có cơ hội hiển thị khi có truy vấn.
- Xác minh website trên Search ConsoleCài và xác minh website qua Google Search Console để theo dõi lỗi thu thập và báo cáo Crawl Stats của Googlebot.
- Cấu hình robots.txt đúng chỗDùng robots.txt để chặn thư mục không cần thiết, nhưng để mở CSS, JS và các thư mục chứa trang quan trọng như trang sản phẩm.
- Gửi sitemap.xml sạch lỗiGửi sitemap.xml cho Google để rút ngắn giai đoạn Discovery, giữ sitemap tự cập nhật và không chứa URL lỗi 404.
- Cấu hình canonical và Schema.orgCấu hình thẻ canonical để Google chọn đúng URL đại diện, rồi thêm Schema.org để Google hiểu thực thể trên trang rõ hơn.
- Giữ máy chủ phản hồi nhanhGiữ TTFB nhanh và theo dõi thời gian phản hồi trong Crawl Stats, vì máy chủ quá tải khiến Googlebot giảm tần suất thu thập và nội dung mới chậm hiển thị.
- Kiểm tra bản render và lỗi crawlDùng công cụ Kiểm tra URL để xem bản Google dựng ra, kiểm lỗi crawl hàng tuần và xem trang quan trọng có dính thẻ noindex không.
Câu hỏi thường gặp về How Google Search Works
Giải đáp trực tiếp các câu hỏi thường gặp về How Google Search Works dựa trên dữ liệu triển khai thực tế, quy trình kiểm thử kỹ thuật và kinh nghiệm thực chiến trên website thật để tối ưu hiệu quả tìm kiếm.
Vì sao trang dùng nhiều JavaScript vẫn có thể bị Google hiểu thiếu nội dung?
Google đánh giá cấu trúc DOM sau khi chạy JavaScript, nên nội dung tải qua AJAX chưa được tối ưu để render có thể không hiện ra với Googlebot. Trong ví dụ website thương mại điện tử mới, sản phẩm tải qua AJAX khiến chỉ trang chủ được index. Sau khi mở chặn và dùng SSR, số trang được index tăng 500% trong 2 tuần.
Vì sao Googlebot giảm tần suất thu thập dữ liệu trên website của tôi?
Googlebot thường giảm tần suất thu thập khi máy chủ phản hồi chậm. Trong báo cáo Crawl Stats của GSC, nếu biểu đồ thời gian phản hồi tăng cao thì máy chủ của bạn đang quá tải. Hệ quả là nội dung mới chậm được hiển thị trên kết quả tìm kiếm, nên giữ TTFB nhanh là việc cần làm sớm.
Đăng thật nhiều bài có làm Googlebot ghé website thường xuyên hơn không?
Không. Đăng nhiều không tự động làm bot vào thường xuyên hơn, đó là một hiểu lầm phổ biến về crawl budget. Chất lượng domain mới là yếu tố quyết định. Nội dung mỏng cũng là lỗi hay gặp: bot vào tới nơi nhưng không đủ lý do để giữ trang lại trong chỉ mục.
Liên kết nội bộ quá sâu ảnh hưởng thế nào tới việc Google thu thập trang?
Cấu trúc liên kết quá sâu khiến Googlebot bỏ cuộc trước khi tới được trang cần thu thập. Googlebot tìm URL qua liên kết và sitemap, nên trang nằm quá xa trong chuỗi liên kết dễ bị bỏ sót. Giữ cấu trúc URL phân cấp rõ và gửi sitemap.xml giúp bot tìm tới trang nhanh hơn.
Google Index là gì và Google dùng Index thế nào khi trả kết quả tìm kiếm?
Google Index là thư viện khổng lồ các trang web đã được lưu trữ từ trước. Khi người dùng tìm kiếm, thuật toán lọc qua hàng tỷ trang trong Index để trả về kết quả trong chưa đầy 1 giây. Trang chưa vào Index thì chưa thể xuất hiện trên kết quả, dù đã đăng lên website.
Trong giai đoạn Indexing, Google phân tích những gì trên một trang?
Trong giai đoạn Indexing, Google phân tích title, heading, render JavaScript và chọn URL canonical. Đây là giai đoạn chuyển đổi dữ liệu thô thành thông tin có cấu trúc. Với ảnh và video, Google đọc metadata đính kèm, nên nội dung trong ảnh cần thuộc tính mô tả.
Giai đoạn Serving dựa vào những yếu tố nào để xếp hạng kết quả?
Ở giai đoạn Serving, thuật toán xếp hạng theo tính liên quan, E-E-A-T và trải nghiệm. Một trang chỉ được xét xếp hạng khi đã qua Crawling và Indexing, nên lỗi ở hai giai đoạn trước sẽ chặn luôn cơ hội hiển thị.
Checklist triển khai cho Google Search gồm những việc nào?
Checklist triển khai gồm năm việc nền: cài và xác minh Search Console, để robots.txt không chặn CSS và JS, giữ sitemap tự cập nhật và không chứa URL lỗi, cấu hình thẻ canonical, và giữ cấu trúc URL phân cấp rõ. Trong năm việc đó, chặn nhầm CSS là lỗi hay gặp nhất.
Googlebot là gì và Googlebot tìm URL mới bằng cách nào?
Googlebot là phần mềm thu thập dữ liệu của Google. Googlebot dùng danh sách URL xây dựng từ các lần thu thập trước và các Sitemaps do quản trị viên cung cấp, đồng thời khám phá URL mới qua liên kết. Googlebot chỉ tải trang khi robots.txt cho phép và render trang bằng Chrome phiên bản mới nhất.
Evergreen Googlebot là gì và ảnh hưởng thế nào tới website dùng JavaScript?
Evergreen Googlebot là Googlebot dùng trình duyệt Chrome phiên bản mới nhất để render trang. Với Evergreen Googlebot, cấu trúc DOM sau khi chạy JavaScript mới là thứ Google thực sự đánh giá. Vì vậy, nội dung quan trọng cần nằm trong HTML hoặc được dựng thành công, và CSS cùng JS không được chặn trong robots.txt.
Google Search Console có cần thiết khi tối ưu cho Google Search không?
Google Search Console cần thiết khi tối ưu cho Google Search, vì xác minh website qua Google Search Console là bước đầu của quy trình triển khai. Báo cáo Crawl Stats trong Google Search Console cho thấy thời gian phản hồi của máy chủ, giúp bạn phát hiện quá tải trước khi Googlebot giảm tần suất thu thập.
Robots.txt khác thẻ noindex thế nào khi kiểm soát Google Search?
Robots.txt quyết định Googlebot có được tải trang hay không ở giai đoạn Crawling, còn thẻ noindex chặn trang khỏi giai đoạn Indexing. Robots.txt nên chặn thư mục không cần thiết và để mở CSS cùng JS. Khi audit, kiểm để trang quan trọng không dính thẻ noindex và thư mục như /product/ không bị robots.txt chặn.
Làm tiếp trên chính website của bạn
Chọn theo điều bạn đang cần: người soi website, nền tảng để tự làm, hay người kèm tới nơi.
Phân tích SEO và GEO Online
Tìm đúng chỗ website đang nghẽn, bàn giao thứ tự sửa và bản đồ nội dung theo DLN™. Học tiếp Mentor thì phí này được trừ vào học phí.
Xem phạm vi phân tíchKhóa học SEO cơ bản Online
6 buổi online về Technical và On-page, đủ nền tảng để tự rà và sửa website của bạn.
Xem lộ trình họcMentor SEO 1 kèm 1 Online
12 buổi trong 4 tuần, làm trực tiếp trên website của bạn cùng Danh Nolan.
Xem cách kèm