

File Robots.txt là một trong những tệp đơn giản nhất trên mọi trang web, nhưng nó cũng là một trong những tệp dễ gây nhầm lẫn nhất.
Nhưng nó lại rất quan trọng trong kế hoạch SEO và chiến lược SEO của bạn.
Chỉ cần một ký tự không đúng vị trí có thể phá hỏng kế hoạch SEO của bạn, đồng thời ngăn các công cụ tìm kiếm và truy cập nội dung quan trọng trên mọi trang web của bạn.
Đây là lý do tại sao cấu hình sai robots.txt rất phổ biến, ngay cả trong số các chuyên gia SEO có kinh nghiệm. Vậy làm thế nào để có file robots.txtchuẩn cho wordpress và cách tạo file robots.txtcho wordpress như thế nào.
Để hiểu rõ hơn, hãy cùng tôi xem qua bài viết này nha.
Tài liệu trả phí
Bản chuyên sâu: Robots.txt chặn admin, tìm kiếm, staging: quy trình viết, thử và nghiệm thu
Bài đọc miễn phí giữ nguyên. Bản chuyên sâu là tài liệu viết riêng: quy trình từng bước, checklist, bảng lỗi và mẫu để làm theo.
- Đọc trên trang học: 6.458 chữ, viết riêng cho mục P1.18 của SQA-200
- PDF: 15 trang, tải về
- Excel: 8 bảng và 52 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
Xem trước bản đầy đủ: ba ảnh chụp từ chính tệp PDF và Excel bạn nhận sau khi mua.
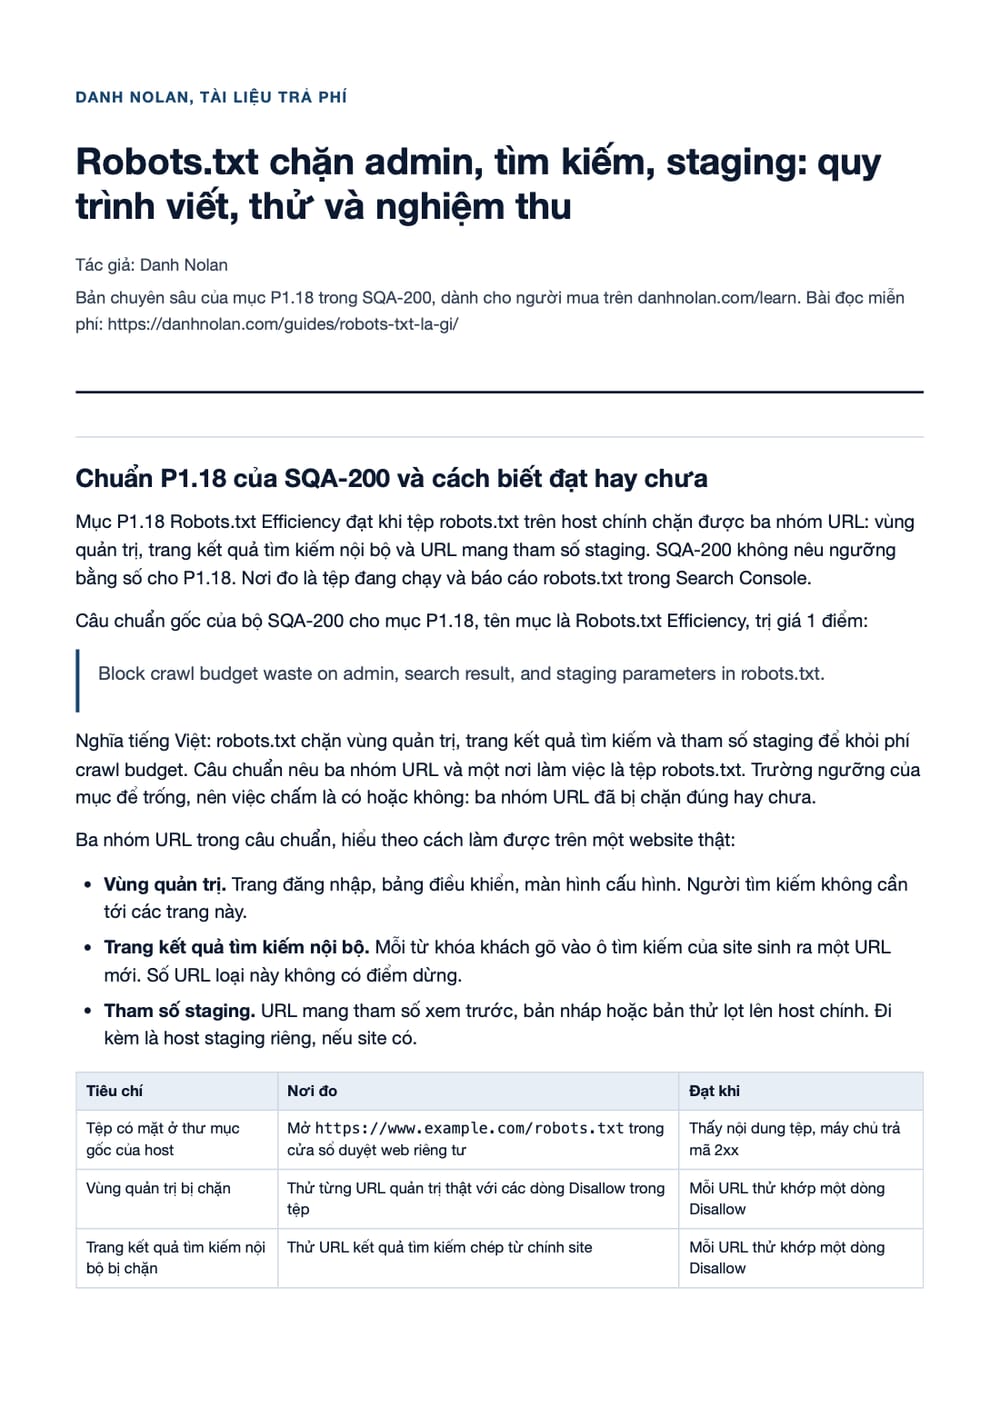
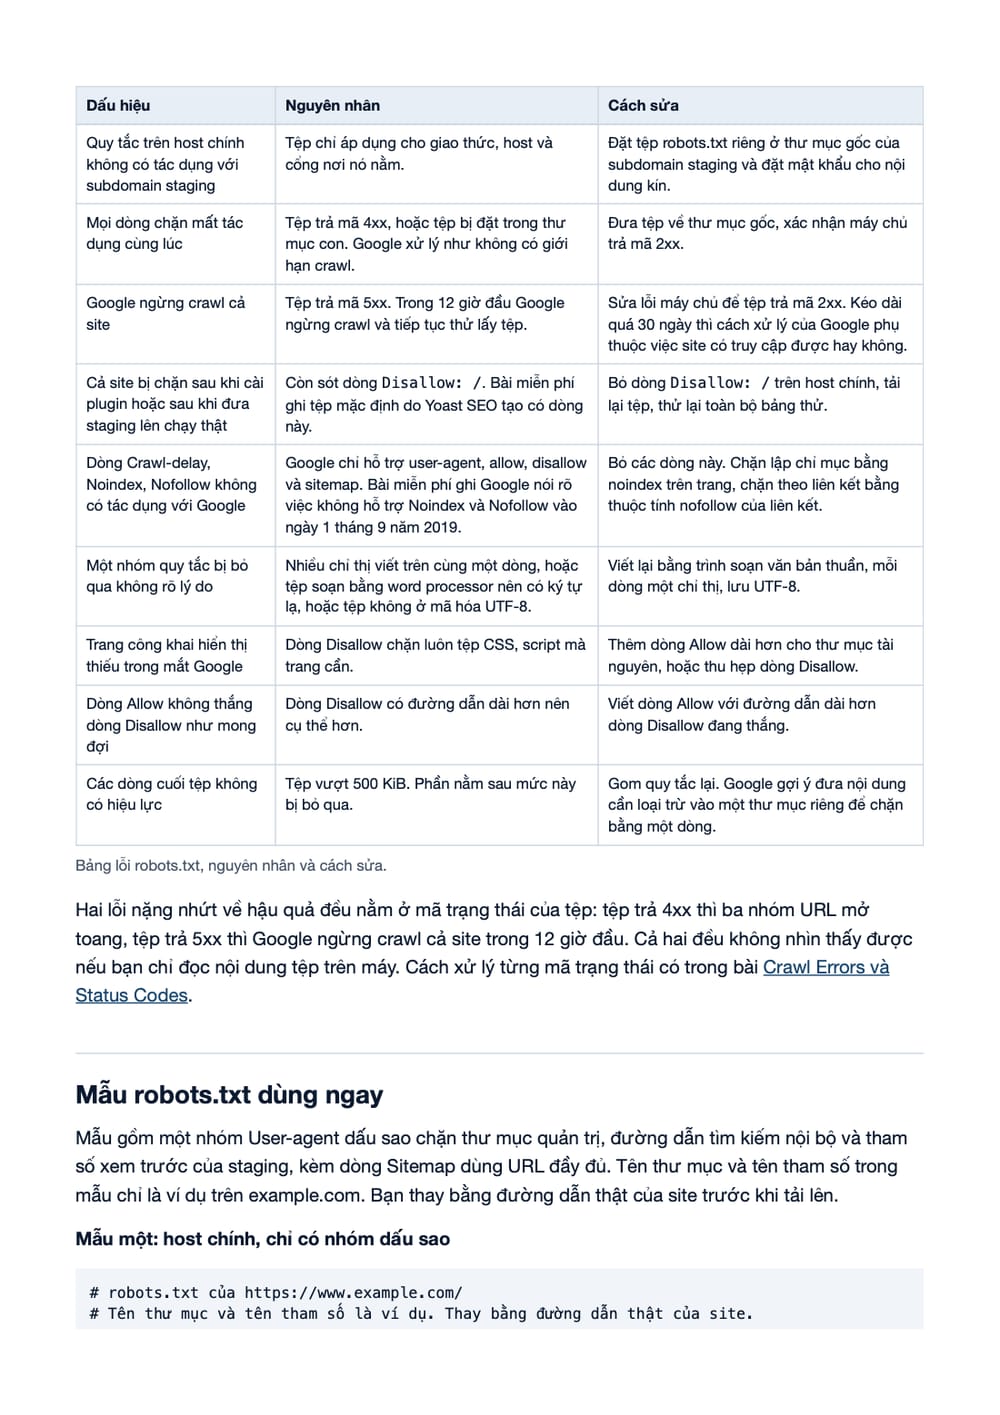
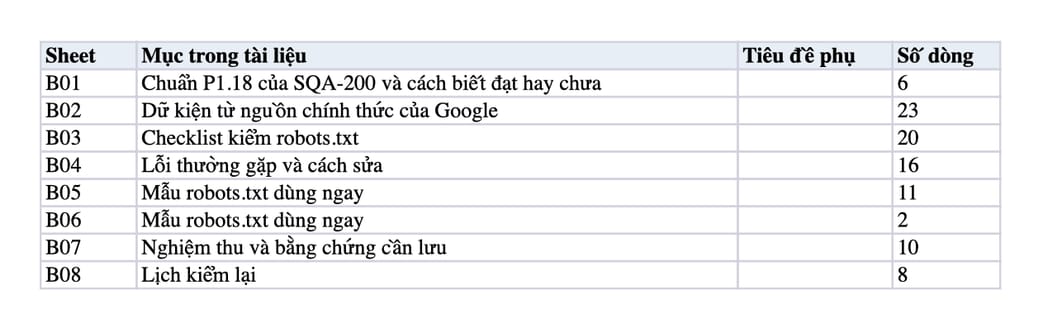
Viết xong tệp thì phải thử từng đường dẫn chứ đừng đọc bằng mắt, vì một dòng thừa chặn được cả thư mục. Công cụ kiểm tra robots.txt miễn phí bên Novaverb xác thực từng quy tắc và từng chỉ thị User-agent, đồng thời cho biết chính sách bạn đang áp cho nhóm crawler của AI (SI - Super Intelligence).
File Robot.txt là gì?
File robot.txt là một tệp văn bản mà quản trị viên web tạo ra để hướng dẫn Bọ Google (Googlebot), Bing có thể hiểu và thu thập dữ liệu trên website của bạn.
Không những thế, ngoài việc thu thập dữ liệu và index nội dung trên website ra, quản trị web có thể thông qua File robot.txt để chặn các thông tin không cần thiết trên website của bạn.
Tệp robots.txt trông như thế nào?
Phần này cho bạn xem hai dạng tệp robots cơ bản. Nhóm đầu nhắm riêng vào Googlebot, khai User-agent là Googlebot rồi Disallow thư mục nogooglebot. Nhóm sau nhắm mọi bot, khai User-agent là dấu sao rồi Allow toàn bộ. Cuối tệp là dòng khai địa chỉ sitemap. Nhìn mẫu một lần là hiểu cấu trúc.
Đây là 2 dạng File robot cơ bản.
# Group 1
User-agent: Googlebot
Disallow: /nogooglebot/
# Group 2
User-agent: *
Allow: /
Sitemap: https://danhnolan.com/
Giải thích thuật ngữ trong File Robot.txt
User-agent (tác nhân người dùng): Phần này là tên của trình thu thập dữ liệu, cho phép vào website để thu thập dữ liệu
Disallow:
Lệnh được sử dụng để yêu cầu User-agent (tác nhân người dùng)không thu thập thông tin URL cụ thể. Chỉ cho phép một dòng “Disalow” là mỗi URL.
Ví dụ: nếu bạn muốn chặn tất cả các công cụ tìm kiếm truy cập vào blog của bạn và tất cả các bài đăng trên blog của mình, tệp robots.txt của bạn có thể trông giống như sau:
User-agent: *
Disallow: /blog
Allow (Only applicable for Googlebot)
Lệnh cho Googlebot biết nó có thể truy cập một trang hoặc thư mục con trên website. Mặc dù trang mẹ hoặc thư mục con của nó có thể không được phép.
Ví dụ: nếu bạn muốn ngăn các công cụ tìm kiếm truy cập vào mọi bài đăng trên blog của mình ngoại trừ một bài đăng, thì tệp robots.txt của bạn có thể trông giống như sau:
User-agent: *
Disallow: /blog
Allow: /blog/allowed-post
Trong ví dụ này, các công cụ tìm kiếm có thể truy cập /blog/allowed-post. Nhưng họ không thể truy cập:
/blog/another-post
/blog/yet-another-post
/blog/download-me.pdf
Sitemap
Sử dụng chỉ thị này để chỉ định vị trí của (các)sitemap cho các công cụ tìm kiếm. Nếu bạn không quen với sitemap, chúng thường bao gồm các trang mà bạn muốn công cụ tìm kiếm thu thập thông tin và lập chỉ mục.
Đây là ví dụ về tệp robots.txt sử dụng lệnh sơ đồ trang web:
User-agent: *
Disallow: /blog/
Allow: /blog/post-title/
Sitemap: https://www.domain.com/sitemap.xml
Thêm sitemap trong tệp robots.txt quan trọng như thế nào? Nếu bạn đã gửi thông qua Search Console, thì nó hơi thừa đối với Google.
Tuy nhiên, nó cho các công cụ tìm kiếm khác như Bing biết nơi tìm sitemap website của bạn, vì vậy nó vẫn là một phương pháp hay.
Lưu ý rằng bạn không cần lặp lại chỉ thị sitemap webite nhiều lần cho mỗi tác nhân người dùng (User-agent).
Ví dụ:
User-agent: Googlebot
Disallow: /blog
Allow: /blog/post-title/
User-agent: Bingbot
Disallow: /services/
Sitemap: https://www.domain.com/sitemap.xml
Google hỗ trợ chỉ thị sơ đồ trang web, cũng như Ask, Bing và Yahoo.
Các lệnh không được hỗ trợ trong File Robot.txt
Các lệnh không được hỗ trợ trong File Robot.txt gồm Crawl-delay, Noindex và Nofollow. Google không còn hỗ trợ Crawl-delay, dù Bing và Yandex vẫn có. Noindex và Nofollow chưa bao giờ được Google hỗ trợ chính thức, và Google nói rõ điều này vào ngày 1 tháng 9 năm 2019.
Dưới đây là các lệnh không còn được Google hỗ trợ nữa, một số lệnh như sau:
Crawl-delay
Trước đây, bạn có thể sử dụng lệnh này để chỉ định độ trễ thu thập thông tin trên website. Ví dụ: nếu bạn muốn Googlebot đợi 5 giây sau mỗi hành động thu thập thông tin, bạn sẽ đặt độ trễ thu thập thông tin thành 5 như sau:
User-agent: Googlebot
Crawl-delay: 5
Google không còn hỗ trợ chỉ thị này, nhưng Bing và Yandex thì có.
Tuy nhiên lời khuyên mà tôi dành cho bạn đó là: nên cẩn thận với lệnh này, đặc biệt bạn có một trang web lớn.
Nếu bạn đặt thời gian trễ thu thập thông tin là 5 giây, thì bạn đang hạn chế các bot thu thập thông tin tối đa 17.280 URL mỗi ngày.
Điều đó không hữu ích lắm nếu bạn có hàng triệu trang, nhưng nó có thể tiết kiệm băng thông nếu bạn có một trang web nhỏ.
Noindex
Chỉ thị này chưa bao giờ được Google hỗ trợ chính thức. Tuy nhiên, một số ý kiến cho rằng Google đã có một số “mã xử lý các quy tắc không được hỗ trợ và chưa được xuất bản (chẳng hạn như noindex)”. Vì vậy, nếu bạn muốn ngăn Google lập chỉ mục tất cả các bài đăng trên blog của mình, bạn có thể sử dụng lệnh sau:
User-agent: Googlebot
Noindex: /blog/
Tuy nhiên, vào ngày 1 tháng 9 năm 2019, Google đã nói rõ rằng chỉ thị này không được hỗ trợ.
Nofollow
Đây là một chỉ thị khác mà Google chưa bao giờ chính thức hỗ trợ và được sử dụng để hướng dẫn các công cụ tìm kiếm không theo liên kết trên các trang và tệp
Ví dụ: nếu bạn muốn ngăn Google theo dõi tất cả các liên kết trên blog của mình, bạn có thể sử dụng lệnh sau:
User-agent: Googlebot
Nofollow: / blog /
Google đã thông báo rằng chỉ thị này chính thức không được hỗ trợ vào ngày 1 tháng 9 năm 2019
Nếu bạn muốn yêu cầu Google không theo các liên kết cụ thể trên một trang, hãy sử dụng thuộc tính liên kết rel = “nofollow”.
File Robot.txt có tác dụng gì với Website
File Robot.txt có tác dụng giúp bạn kiểm soát nơi công cụ tìm kiếm được và không được truy cập trên website. Nó giúp ngăn thu thập nội dung trùng lặp và trang tìm kiếm nội bộ, giữ riêng tư trang dàn dựng, chống quá tải máy chủ và tránh lãng phí ngân sách thu thập.
Có một tệp robots.txt không quan trọng đối với nhiều trang web, đặc biệt là những trang web nhỏ.
Nó cho phép bạn kiểm soát nhiều hơn những nơi mà các công cụ tìm kiếm có thể và không thể truy cập vào trang web của bạn và điều đó có thể trợ giúp những việc như:
- Ngăn chặn việc thu thập nội dung trùng lặp;
- Giữ các phần của một trang web ở chế độ riêng tư (ví dụ: trang web dàn dựng của bạn);
- Ngăn chặn việc thu thập thông tin các trang kết quả tìm kiếm nội bộ;
- Chống quá tải cho máy chủ;
- Ngăn Google lãng phí “ngân sách thu thập thông tin”;
- Ngăn hình ảnh, video và tệp tài nguyên xuất hiện trong kết quả tìm kiếm của Google;
Lưu ý nhỏ:mặc dù Google thường không lập chỉ mục các trang web bị chặn trong robots.txt, nhưng điều đó không đảm bảo nó không xuất hiện trên công cụ tìm kiếm.
Cách tìm tệp robots.txt của bạn
Để tìm file robot.txt của bạn, bạn chỉ cần mở trình duyệt web lên. Sau đó gõ domain.com/robots.txt. Nếu bạn thấy thứ gì đó như vậy, thì bạn có tệp robots.txt:
Cách tạo File Robots.txt cho WordPress
Nếu bạn không phải là một coder thực sự, việc tạo file robots.txtrất khó khăn. Phải can thiệp rất nhiều thứ, nhưng bây giờ WordPress rất phổ biến.
Nên Cách tạo File Robots.txtcho WordPress cũng trở nên dễ dàng hơn trước rất nhiều. Các bạn xem hướng dẫn sau đây nha.
Tạo file robots.txt với Rank Math SEO
Đầu tiên các bạn truy cập vào Dasboard » Rank Math SEO » General Settings » Edit robots.txt
Tạo file robots.txt bằng Yoast SEO
Nếu bạn đang sử dụng Yoast SEO thì nó có sẵn tính năng tạo file robots.txt cho bạn. Bạn có thể tạo và chỉnh sửa trực tiếp từ khu vực admin.
Đơn giản đi đến menu SEO » Tools và chọn File Editor
Nếu bạn sử dụng giao diện tiếng Việt:
Ngay sau đó Yoast SEO sẽ hiển thị file robots.txt bạn đã có.
Nếu không có file robots.txt. Yoast SEO sẽ tạo giúp bạn bằng bấm vào nút dưới đây.
Mặc định thì file robots.txt được Yoast SEO tạo có cấu trúc như sau.
User-agent: *
Disallow: /
Lưu ý là:Khi các bạntạo File Robots.txt cho WordPress,nếu như các bạn không biết cách chỉnh sửa trong File function.php. Vậy các bạn hãy cài đặt Plugin Rank Math Seo hoặc Yoast SEO đểtạo File Robot.txtnày nha.
Tạo file robots.txt bằng cách thủ công sử dụng FTP
Với phương pháp này bạn cần sử dụng FTP client để chỉnh sửa file trên VPS hoặc nếu bạn dùng Hosting có Cpanel có thể vào File Manager để chỉnh sửa.
Truy cập vào thư mục chính trên WordPress bằng FTP và edit trực tiếp như dưới đây.
Nếu bạn không thấy file robots.txt nào, hãy tạo bằng cách chuột phải và creat new file.
File robots.txt đơn giản chỉ là một file text bạn có thể download nó về edit bằng notepad, notepad++ hoặc phần mềm tương tự, save lại và upload lên lại hosting là được.
Các phương pháp hay nhất về File Robots.txt
Có rất nhiều sai lầm khi tạo File Robot.txt, sau đây là một số lời khuyên dành cho những ai chưa có kinh nghiệm.
Sử dụng một dòng mới cho mỗi chỉ thị
Mỗi chỉ thị nên nằm trên một dòng mới. Nếu không, nó sẽ gây nhầm lẫn cho các công cụ tìm kiếm.
Robot.txt xấu:
User-agent: * Disallow: /directory/ Disallow: /another-directory/Robot.txt Good:
User-agent: *
Disallow: /directory/
Disallow: /another-directory/Sử dụng ký tự đại diện để đơn giản hóa hướng dẫn
Bạn không chỉ có thể sử dụng các ký tự đại diện (*) để áp dụng các lệnh cho tất cả các tác nhân người dùng (User-agent) mà còn để khớp các mẫu URL khi khai báo các lệnh.
Ví dụ: nếu bạn muốn ngăn các công cụ tìm kiếm truy cập vào các URL danh mục sản phẩm được tham số hóa trên website của bạn, bạn có thể liệt kê chúng như sau:
User-agent: *
Disallow: /products/t-shirts?
Disallow: /products/hoodies?
Disallow: /products/jackets?
Nhưng điều đó không hiệu quả lắm. Sẽ tốt hơn nếu đơn giản hóa mọi thứ bằng một ký tự đại diện như sau:
User-agent: *
Disallow: /products/*?
Ví dụ này chặn các công cụ tìm kiếm thu thập thông tin tất cả các URL trong thư mục con / product / có chứa dấu chấm hỏi. Nói cách khác, mọi URL danh mục sản phẩm được tham số hóa.
Sử dụng “$” để chỉ định phần cuối của URL
Nếu bạn muốn ngăn các công cụ tìm kiếm truy cập vào tất cả các tệp.pdf trên website của bạn, File robots.txt của bạn có thể trông giống như sau:
User-agent: *
Disallow: /*.pdf$
Trong ví dụ này, công cụ tìm kiếm không thể truy cập bất kỳ URL nào kết thúc bằng.pdf. Điều đó có nghĩa là họ không thể truy cập /file.pdf, nhưng họ có thể truy cập /file.pdf?id=68937586 vì điều đó không kết thúc bằng “.pdf”.
Sử dụng tính cụ thể để tránh các lỗi không cố ý
Việc không cung cấp các hướng dẫn cụ thể khi thiết lập có thể có tác động nghiêm trọng đến SEO của bạn. Ví dụ: giả sử rằng bạn có một trang web đa ngôn ngữ và bạn đang làm việc trên một phiên bản tiếng Đức sẽ có sẵn trong thư mục con / de /.
Bạn chưa cấu hình để nó hoạt động, vậy bạn không muốn Google index nó phải không nào.
Tệp robots.txt bên dưới sẽ ngăn các công cụ tìm kiếm truy cập vào thư mục con đó và mọi thứ trong đó:
User-agent: *
Disallow: /de
Nhưng nó cũng sẽ ngăn các công cụ tìm kiếm thu thập thông tin của bất kỳ trang hoặc tệp nào bắt đầu bằng /de.
Ví dụ:
/designer-dresses/
/delivery-information.html
/depeche-mode/t-shirts/
/definitely-not-for-public-viewing.pdf
Trong trường hợp này, giải pháp rất đơn giản: thêm một dấu gạch chéo.
User-agent: *
Disallow: /de/
File Robot.txt mẫu các bạn tham khảo
File Robot.txt mẫu gồm các cấu hình thường gặp: không giới hạn bot, chặn tất cả bot bằng Disallow: /, chặn một thư mục con nhưng dùng Allow mở lại một trang, chặn một tệp cụ thể, chặn mọi tệp PDF, và chặn URL có ký tự lạ với Googlebot.
Không giới hạn cho các Bot
User-agent: *
Disallow:
Chặn tất cả các bot
User-agent: *
Disallow: /
Chặn bot index thư mục con
User-agent: *
Disallow: /folder/
Chặn một thư mục con cho tất cả các bot
Đoạn mẫu này chặn một thư mục con với mọi bot. Bạn khai User-agent là dấu sao để áp cho tất cả, rồi Disallow chính thư mục đó. Sau đó dùng dòng Allow để mở lại riêng một trang bên trong, ở đây là page.html. Chặn cả thư mục nhưng vẫn chừa được một trang cần giữ.
User-agent: *
Disallow: / folder /
Allow: /folder/page.html
Chặn một tệp cho tất cả các bot
Đoạn mẫu này chặn đúng một tệp với mọi bot. Bạn khai User-agent là dấu sao để áp cho tất cả, rồi Disallow đường dẫn tới chính tệp đó, ở đây là một tệp PDF. Cách này hợp khi bạn chỉ muốn giấu vài tài liệu lẻ chứ không giấu cả thư mục.
User-agent: *
Disallow: /this-is-a-file.pdf
Chặn một loại tệp (PDF) cho tất cả các bot
User-agent: *
Disallow: /*.pdf$
Chặn tất cả các URL bị Google index ký tự lạ
User-agent: Googlebot
Disallow: /*?
Cách kiểm tra tệp robots.txt của bạn để tìm lỗi
Để thực hiện việc này, hãy thường xuyên kiểm tra các vấn đề liên quan đến robots.txt trong báo cáo “Mức độ phù hợp” trong Search Console. Dưới đây là một số lỗi bạn có thể thấy, ý nghĩa của chúng và cách bạn có thể sửa chúng.
Lưu ý:Dán URL vào công cụ Kiểm tra URL của Google trong Search Console. Nếu nó bị chặn bởi robots.txt, bạn sẽ thấy một cái gì đó như sau:
Gửi URL bị chặn bởi Robot.txt
Điều này có nghĩa là ít nhất một trong các URL trong (các) sitemap đã gửi của bạn bị robots.txt chặn. Nếu bạn đã tạo sơ đồ website của bạn một cách chính xác nhưng vẫn bị Google bot chặn, vậy bạn hãy xem lại trang nào bị ảnh hưởng, sau đó điều chỉnh tệp robots.txt của bạn cho phù hợp để xóa khối cho trang đó.
Bạn có thể sử dụng trình kiểm tra robots.txt của Google để xem chỉ thị nào đang chặn nội dung. Sau đó tìm cách khắc phục
Đã lập chỉ mục, mặc dù bị chặn bởi robots.txt
Điều này có nghĩa là một số nội dung bị robots.txt chặn vẫn được lập chỉ mục trong Google.
Vậy làm thế nào để khắc phục tình trạng này? Xóa khối thu thập thông tin và thay vào đó sử dụng đoạn code <meta name=”robots” content=”noindex” /> để ngăn chặn Google index.
File Robots.txtlà một tệp đơn giản nhưng mạnh mẽ và nó có tác dụng rất lớn đối SEO đặc biệt các dịch vụ SEO. Nếu bạn biết tận dụng và khai thác tốt, chắc chắn thứ hạng từ khóa của bạn sẽ vượt ngoài mong đợi
Bước tiếp theo
Muốn tự làm được việc này trên website của bạn?
SEO Master hướng dẫn làm SEO trong 24 buổi, từ tư duy nền tảng tới triển khai và đo lường trên website thật.
Tài liệu trả phí
Bản chuyên sâu: Robots.txt chặn admin, tìm kiếm, staging: quy trình viết, thử và nghiệm thu
Bài đọc miễn phí giữ nguyên. Bản chuyên sâu là tài liệu viết riêng: quy trình từng bước, checklist, bảng lỗi và mẫu để làm theo.
- Đọc trên trang học: 6.458 chữ, viết riêng cho mục P1.18 của SQA-200
- PDF: 15 trang, tải về
- Excel: 8 bảng và 52 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
Định nghĩaFile Robots.txt là tệp văn bản mà quản trị viên web tạo ra để hướng dẫn Googlebot, Bing thu thập dữ liệu trên website, giúp bạn kiểm soát nơi công cụ tìm kiếm được và không được truy cập.
Cách tạo và kiểm tra File Robots.txt cho WordPress
Các bước giúp bạn tạo File Robots.txt cho WordPress, viết đúng chỉ thị, rồi thử từng đường dẫn để một dòng thừa không chặn nhầm nội dung quan trọng.
- Kiểm tra tệp đang cóMở trình duyệt web và gõ domain.com/robots.txt. Nếu thấy nội dung tệp hiện ra thì website đã có File Robots.txt để chỉnh sửa tiếp.
- Mở trình chỉnh sửa tệpVới Rank Math SEO, vào General Settings rồi chọn Edit robots.txt. Với Yoast SEO, vào menu SEO, chọn Tools rồi File Editor để tạo hoặc sửa tệp.
- Khai báo User-agent và chỉ thịKhai User-agent cho bot cần áp, dùng Disallow để chặn đường dẫn, Allow để mở lại một trang, và đặt mỗi chỉ thị trên một dòng mới.
- Dùng ký tự đại diện đúng chỗDùng dấu sao để khớp mẫu URL, dấu $ để chỉ định phần cuối URL, và thêm dấu gạch chéo cuối thư mục để không chặn nhầm trang cùng tiền tố.
- Khai địa chỉ sitemapThêm dòng Sitemap ở cuối tệp để Bing và các công cụ tìm kiếm khác biết nơi tìm sitemap. Không cần lặp lại chỉ thị cho mỗi User-agent.
- Thử từng đường dẫn sau khi lưuDán URL vào công cụ Kiểm tra URL của Google trong Search Console và theo dõi báo cáo Mức độ phù hợp để phát hiện URL bị robots.txt chặn nhầm.
Câu hỏi thường gặp về File Robots.txt
Giải đáp trực tiếp các câu hỏi thường gặp về File Robots.txt dựa trên dữ liệu triển khai thực tế, quy trình kiểm thử kỹ thuật và kinh nghiệm thực chiến trên website thật để tối ưu hiệu quả tìm kiếm.
Vì sao chỉ một ký tự sai trong robots.txt cũng làm hỏng SEO?
Một ký tự không đúng vị trí có thể ngăn công cụ tìm kiếm truy cập nội dung quan trọng trên website. Ví dụ, chặn thư mục con /de mà thiếu dấu gạch chéo cuối sẽ chặn luôn mọi trang bắt đầu bằng /de, như /delivery-information.html. Cấu hình sai robots.txt rất phổ biến, kể cả với người làm SEO có kinh nghiệm.
Trang đã chặn trong robots.txt sao vẫn xuất hiện trên Google?
Robots.txt chỉ chặn thu thập, Google thường không lập chỉ mục trang bị chặn nhưng trang vẫn có thể xuất hiện trên công cụ tìm kiếm. Search Console khi đó báo Đã lập chỉ mục, mặc dù bị chặn bởi robots.txt. Cách khắc phục là xóa khối thu thập thông tin rồi dùng đoạn code ngăn Google index.
Vì sao Search Console báo URL trong sitemap bị robots.txt chặn?
Lỗi Gửi URL bị chặn bởi Robot.txt nghĩa là ít nhất một URL trong sitemap đã gửi đang bị robots.txt chặn. Bạn xem lại trang nào bị ảnh hưởng, dùng trình kiểm tra robots.txt của Google để tìm chỉ thị đang chặn, rồi điều chỉnh tệp để bỏ khối cho trang đó.
Không biết code thì tạo robots.txt cho WordPress bằng cách nào?
Bạn cài plugin Rank Math SEO hoặc Yoast SEO, cả hai đều có sẵn trình sửa robots.txt trong khu vực quản trị. Nếu chưa có tệp, Yoast SEO tạo giúp bằng một nút bấm với cấu trúc mặc định. Cách thủ công qua FTP hoặc File Manager của Cpanel cũng được, vì robots.txt chỉ là tệp văn bản.
Disallow và Allow trong robots.txt khác biệt thế nào?
Disallow yêu cầu User-agent không thu thập một URL hoặc thư mục cụ thể, mỗi dòng Disallow cho một URL. Allow cho Googlebot biết được truy cập một trang hoặc thư mục con, dù thư mục mẹ bị chặn. Ví dụ, chặn cả /blog/ nhưng vẫn mở /blog/allowed-post.
Google không còn hỗ trợ những lệnh nào trong robots.txt?
Google không hỗ trợ Crawl-delay, Noindex và Nofollow trong robots.txt. Crawl-delay vẫn được Bing và Yandex hỗ trợ. Noindex và Nofollow chưa bao giờ được Google hỗ trợ chính thức, và Google nói rõ điều đó vào ngày 1 tháng 9 năm 2019. Muốn Google không theo một liên kết cụ thể, bạn dùng thuộc tính rel nofollow.
Đặt Crawl-delay 5 giây thì bot thu thập được tối đa bao nhiêu URL?
Với Crawl-delay 5 giây, bot bị giới hạn tối đa 17.280 URL mỗi ngày. Con số đó không đủ nếu website có hàng triệu trang, nhưng có thể tiết kiệm băng thông cho website nhỏ. Google không còn hỗ trợ Crawl-delay, còn Bing và Yandex vẫn đọc chỉ thị đó, nên cần cẩn thận với website lớn.
Ký tự dấu sao và dấu $ dùng để làm gì trong robots.txt?
Dấu sao là ký tự đại diện, áp lệnh cho mọi User-agent hoặc khớp mẫu URL, ví dụ chặn mọi URL trong thư mục /product/ có chứa dấu chấm hỏi. Dấu $ chỉ định phần cuối URL, nên quy tắc cho .pdf chặn /file.pdf nhưng không chặn /file.pdf?id=68937586.
File Robots.txt có cần thiết cho website nhỏ không?
File Robots.txt không quan trọng với nhiều website, đặc biệt là website nhỏ. Tuy vậy, File Robots.txt vẫn giúp kiểm soát nơi công cụ tìm kiếm được truy cập, ngăn thu thập nội dung trùng lặp, giữ riêng tư trang dàn dựng, chống quá tải máy chủ và tránh lãng phí ngân sách thu thập.
Có nên dùng Noindex trong File Robots.txt không?
Không nên dùng Noindex trong File Robots.txt, vì Google chưa bao giờ hỗ trợ chỉ thị Noindex và đã nói rõ vào ngày 1 tháng 9 năm 2019 rằng chỉ thị Noindex không được hỗ trợ. Muốn ngăn Google index một trang, bạn bỏ khối chặn thu thập trong robots.txt rồi dùng đoạn code ngăn Google index.
Nên bắt đầu tạo File Robots.txt cho WordPress từ đâu?
Nên bắt đầu tạo File Robots.txt cho WordPress bằng việc gõ domain.com/robots.txt để xem website đã có tệp chưa. Sau đó dùng Rank Math SEO hoặc Yoast SEO để tạo và sửa tệp trong khu vực quản trị, hoặc sửa thủ công qua FTP. Viết xong, bạn thử từng đường dẫn bằng công cụ Kiểm tra URL trong Search Console.
Có cần khai Sitemap trong File Robots.txt không?
Có, khai Sitemap trong File Robots.txt vẫn là một phương pháp hay. Nếu đã gửi sitemap qua Search Console thì dòng Sitemap hơi thừa đối với Google, nhưng dòng Sitemap cho Bing và các công cụ tìm kiếm khác biết nơi tìm sitemap. Google, Ask, Bing và Yahoo đều hỗ trợ chỉ thị Sitemap.
Làm tiếp trên chính website của bạn
Chọn theo điều bạn đang cần: người soi website, nền tảng để tự làm, hay người kèm tới nơi.
Phân tích SEO và GEO Online
Tìm đúng chỗ website đang nghẽn, bàn giao thứ tự sửa và bản đồ nội dung theo DLN™. Học tiếp Mentor thì phí này được trừ vào học phí.
Xem phạm vi phân tíchKhóa học SEO cơ bản Online
6 buổi online về Technical và On-page, đủ nền tảng để tự rà và sửa website của bạn.
Xem lộ trình họcMentor SEO 1 kèm 1 Online
12 buổi trong 4 tuần, làm trực tiếp trên website của bạn cùng Danh Nolan.
Xem cách kèm