

Trong SEO, “lai intent” (mixed intent) là nhóm truy vấn mà kết quả tìm kiếm thể hiện nhiều mục đích người dùng cùng lúc, khiến việc chọn loại trang và cấu trúc nội dung khó hơn bình thường.
Cannibalization (tranh chấp từ khóa) thường xảy ra khi nhiều URL trên cùng một website cạnh tranh cho cùng một cụm truy vấn, làm tín hiệu bị phân tán và khó ổn định thứ hạng.
Phạm vi bài viết: tập trung vào cách xử lý truy vấn lai intent và giảm cannibalization thông qua (1) quyết định tách/gộp trang, (2) lựa chọn canonical hay redirect, (3) mapping keyword → URL, và (4) theo dõi trùng lặp trong vận hành thực tế.
Tài liệu trả phí
Bản đầy đủ: Xử lý truy vấn lai intent & tránh cannibalization: tách/gộp, canonical vs redirect
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 8.786 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 14 bước, bảng lỗi, mẫu, nghiệm thu (5 bảng)
- PDF: 23 trang, tải về
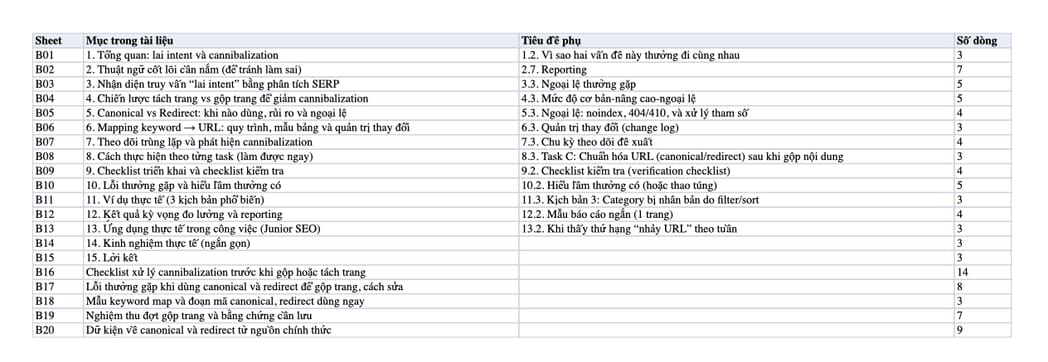
- Excel: 20 bảng và 29 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
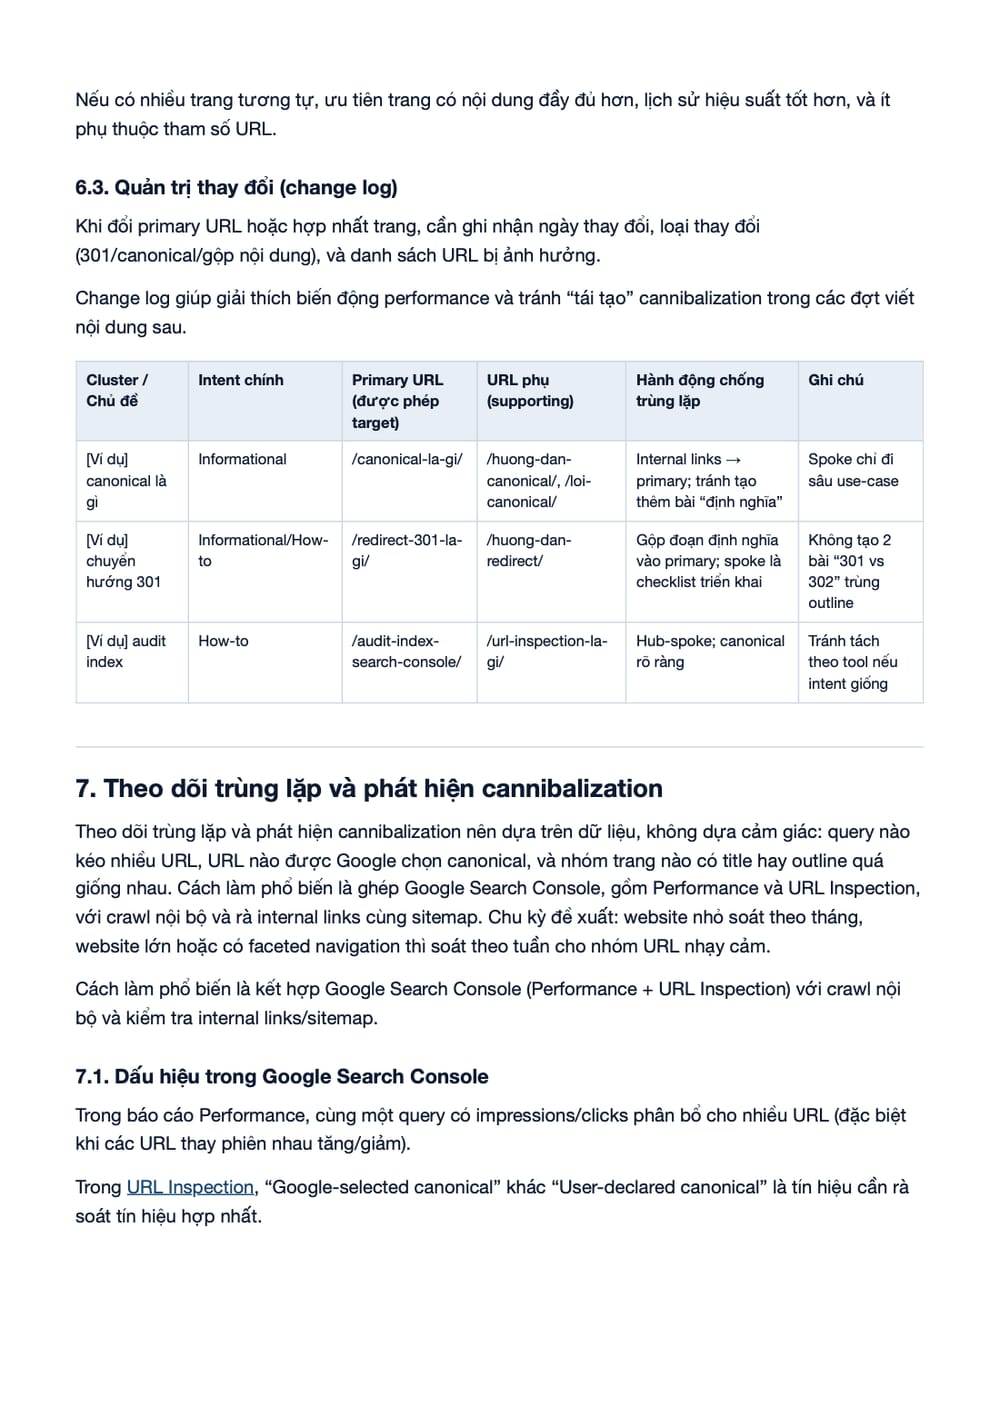
Xem trước bản đầy đủ: ba ảnh chụp từ chính tệp PDF và Excel bạn nhận sau khi mua.
1. Tổng quan: lai intent và cannibalization
Lai intent là tình huống SERP hiển thị đồng thời nhiều “dạng đáp án” (ví dụ: định nghĩa, hướng dẫn, danh mục sản phẩm, trang so sánh), hàm ý Google đang phục vụ nhiều nhu cầu trong cùng truy vấn.
Cannibalization là hiện tượng nhiều URL nội bộ cùng nhắm một cụm truy vấn/ý định, khiến Google khó chọn “trang chuẩn” (canonical) và người dùng phân tán điểm đến.
1.1. Định nghĩa ngắn gọn (dùng trong vận hành)
Lai intent (mixed intent): truy vấn có ≥2 ý định hợp lý và SERP phản ánh điều đó bằng nhiều loại trang khác nhau.
Cannibalization: nhiều URL trên cùng site có nội dung/ý định chồng lấp và cùng cạnh tranh hiển thị cho một tập truy vấn tương tự.
1.2. Vì sao hai vấn đề này thường đi cùng nhau
Truy vấn lai intent dễ dẫn đến việc “mỗi team viết một kiểu”, tạo nhiều trang na ná nhau: bài định nghĩa, bài hướng dẫn, landing bán hàng... mà không có quy ước URL chính.
Khi tín hiệu nội bộ (internal links, sitemap, canonical, redirect) không thống nhất, Google có thể chọn một URL khác với ý muốn của bạn hoặc thay đổi URL hiển thị theo thời gian.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Khía cạnh, Lai intent, Cannibalization, Tín hiệu kiểm tra nhanh). Xem bản đầy đủ
2. Thuật ngữ cốt lõi cần nắm (để tránh làm sai)
Thuật ngữ cốt lõi cần nắm ở đây gồm bảy mục: search intent, SERP analysis, keyword cluster, content brief, audit index, internal linking và reporting. Nhóm này có mặt trong quy trình xử lý intent và trùng lặp, nên cần định nghĩa đủ chặt để cả người lẫn AI đọc và trích dẫn thống nhất. Nắm sai thì đội nội dung, SEO và dev dễ chọn nhầm công cụ, ví dụ dùng canonical thay cho redirect, hoặc triển khai lệch mục tiêu.
Nếu không thống nhất định nghĩa, đội nội dung/SEO/dev dễ chọn sai công cụ (ví dụ dùng canonical thay vì redirect) hoặc triển khai lệch mục tiêu.
2.1. Search Intent
Search Intent là mục đích người dùng muốn đạt được khi tìm kiếm (ví dụ: học khái niệm, so sánh, mua, tải, tìm địa điểm).
Trong thực hành SEO, intent thường được suy ra bằng cách quan sát SERP (loại trang đang xếp hạng, SERP features) và ngữ nghĩa truy vấn.
2.2. SERP analysis
SERP analysis là thao tác phân tích trang kết quả tìm kiếm để suy luận intent, mức cạnh tranh và “format nội dung” phù hợp.
Đầu ra tối thiểu nên gồm: nhóm intent chính/phụ, loại trang chủ đạo, SERP features nổi bật, và khoảng trống nội dung.
2.3. Keyword cluster
Keyword cluster là nhóm từ khóa/truy vấn có quan hệ ngữ nghĩa và/hoặc chia sẻ cùng intent, có thể phục vụ bằng một URL trung tâm (pillar) hoặc cụm URL theo cấu trúc.
Mục tiêu của clustering là giảm trùng lặp chủ đề và hỗ trợ mapping keyword → URL.
2.4. Content brief
Content brief là tài liệu hướng dẫn viết nội dung dựa trên intent và SERP, mô tả rõ phạm vi, cấu trúc, bằng chứng cần có, và tiêu chí hoàn thành.
Brief tốt giúp giảm việc “viết hai bài cho cùng một ý”, từ đó giảm cannibalization ngay từ đầu.
2.5. Audit index
Audit index là hoạt động rà soát tình trạng lập chỉ mục (indexing) của URL: URL nào được index, URL nào bị loại trừ, và vì sao Google chọn canonical khác với bạn (nếu có).
Thực hành phổ biến: dùng Google Search Console (URL Inspection + báo cáo Indexing) kết hợp crawl nội bộ để đối chiếu.
2.6. Internal linking
Internal linking là hệ thống liên kết giữa các trang trong cùng website, giúp người dùng điều hướng và giúp công cụ tìm kiếm hiểu cấu trúc/chủ đề.
Trong xử lý trùng lặp, internal links là tín hiệu mạnh để “đẩy” về URL chủ (trang bạn muốn được xem là canonical).
2.7. Reporting
Reporting là quy trình đo lường-tổng hợp-diễn giải số liệu SEO theo chu kỳ (tuần/tháng), gắn với mục tiêu và hành động tiếp theo.
Trong bối cảnh cannibalization, reporting cần theo dõi “một query có bao nhiêu URL cạnh tranh” và “URL nào được Google chọn canonical”.
Bản đầy đủ của mục này có thêm: bảng 7 dòng (cột: Thuật ngữ, Định nghĩa vận hành, Đầu ra tối thiểu, Liên quan trực tiếp đến). Xem bản đầy đủ
3. Nhận diện truy vấn “lai intent” bằng phân tích SERP
Mục tiêu của SERP analysis ở đây là xác định: (1) intent nào đang chiếm ưu thế, (2) có cần “một trang đa-intent” hay tách ra nhiều trang, và (3) đâu là tín hiệu SERP khiến Google chia kết quả.
Đối với Junior SEO, cách làm hiệu quả là biến quan sát SERP thành checklist có thể lặp lại, thay vì cảm tính.
3.1. Dấu hiệu SERP cho thấy truy vấn lai intent
Top kết quả chứa nhiều kiểu trang khác nhau: bài định nghĩa, bài “how-to”, trang danh mục, trang so sánh/đánh giá, hoặc landing chuyển đổi.
SERP features thay đổi theo thời điểm/thiết bị/vị trí (ví dụ có Local Pack, Shopping, PAA), khiến intent “nở ra” theo ngữ cảnh.
3.2. Cách chấm điểm intent (thực dụng)
Gán điểm intent dựa trên tỷ lệ loại trang trong top 10 (ví dụ 6/10 là guide → informational mạnh).
Nếu intent phụ vẫn chiếm tỷ lệ đáng kể (ví dụ 3-4/10), cân nhắc trang “đa-intent” hoặc cấu trúc hub-spoke.
3.3. Ngoại lệ thường gặp
Với truy vấn brand hoặc truy vấn điều hướng, SERP có thể “lệch” về trang chủ/brand page dù intent còn lại tồn tại.
Với truy vấn YMYL hoặc chủ đề cần độ tin cậy cao, format thường thiên về tài liệu chuyên sâu thay vì trang “tổng hợp mỏng”.
Bản đầy đủ của mục này có thêm: bảng 5 dòng (cột: Tín hiệu trong SERP, Gợi ý intent, Hàm ý chọn loại trang, Rủi ro nếu làm sai). Xem bản đầy đủ
4. Chiến lược tách trang vs gộp trang để giảm cannibalization
Chiến lược tách trang hay gộp trang là điểm rẽ quan trọng để giảm cannibalization: tách sai thì sinh trùng lặp, gộp sai thì trang quá rộng và khó đáp ứng intent chính. Cách làm thực dụng là dựa trên ba khác biệt: khác biệt intent, khác biệt nội dung bắt buộc, và khác biệt chuyển đổi. Gộp khi các truy vấn chia sẻ cùng intent chính; tách khi người dùng cần điểm đến khác nhau. Với truy vấn lai intent, hub cùng spoke giúp phủ nhiều nhu cầu mà khỏi sinh ra trang na ná nhau.
Cách tiếp cận thực dụng là dùng ma trận quyết định dựa trên khác biệt intent, khác biệt nội dung bắt buộc, và khác biệt chuyển đổi.
4.1. Nguyên lý chung
Gộp khi các truy vấn chia sẻ cùng intent chính và có thể giải quyết trong một hành trình đọc hợp lý; ưu tiên “một URL mạnh”.
Tách khi intent khác nhau rõ rệt hoặc người dùng cần điểm đến khác nhau (ví dụ: “hướng dẫn” vs “bảng giá/mua”).
4.2. Cấu trúc thực tế: hub-spoke (pillar + supporting pages)
Với truy vấn lai intent, một trang hub có thể phục vụ intent chính và liên kết sang các trang spoke phục vụ intent phụ chuyên sâu.
Cấu trúc này giúp tránh tạo nhiều trang “na ná nhau” và vẫn phủ được nhiều nhu cầu, nếu internal link và anchor text nhất quán.
4.3. Mức độ cơ bản-nâng cao-ngoại lệ
Mức độ cơ bản là gộp nội dung trùng, cập nhật một trang chuẩn, và tách khi intent khác nhau rõ. Mức nâng cao dùng hub cùng spoke, thêm breadcrumb và schema để cấu trúc chặt hơn. Ngoại lệ hay gặp là faceted navigation và filters, lúc đó cần kiểm soát index cùng canonical để tránh nhân bản URL. Ba mức này đi kèm bảng tiêu chí gộp hay tách, dựa trên intent chính, nội dung bắt buộc, chuyển đổi và rủi ro.
Nâng cao: dùng hub-spoke + breadcrumb + schema; ngoại lệ: faceted navigation/filters cần kiểm soát index/canonical để tránh nhân bản URL.
Bản đầy đủ của mục này có thêm: bảng 5 dòng (cột: Tiêu chí, Gộp (1 URL), Tách (nhiều URL), Gợi ý triển khai). Xem bản đầy đủ
5. Canonical vs Redirect: khi nào dùng, rủi ro và ngoại lệ
Canonical và redirect đều là tín hiệu hợp nhất, nhưng khác mục tiêu: redirect chuyển người dùng và bot sang URL mới, còn canonical chỉ gợi ý URL ưu tiên khi nội dung tương tự. Dùng canonical khi cần giữ nhiều URL tồn tại như biến thể, tham số, bản in, tracking. Dùng redirect 301 khi URL đã đổi nhà hoặc khi bạn hợp nhất dứt khoát. Rủi ro thường gặp là chain, loop, và Google chọn canonical khác nếu tín hiệu mâu thuẫn. Ngoại lệ gồm noindex cho trang lọc nội bộ, và 404 hay 410 khi nội dung không còn.
Google có thể tự chọn canonical khác với URL bạn chỉ định, nên triển khai cần đồng bộ thêm các tín hiệu như internal links và sitemap.
5.1. Canonical dùng khi nào
Dùng canonical khi bạn cần giữ nhiều URL tồn tại (ví dụ biến thể, tham số, bản in, tracking) nhưng muốn gợi ý một URL chuẩn để gom tín hiệu.
Canonical phù hợp khi nội dung “rất giống nhau” và không nhất thiết phải chuyển hướng người dùng.
5.2. Redirect dùng khi nào
Dùng redirect (thường là 301) khi một URL đã “đổi nhà” hoặc khi bạn quyết định hợp nhất nội dung và không muốn người dùng/Google truy cập URL cũ nữa.
Redirect đặc biệt hữu ích trong di chuyển URL, gom bài trùng, và chuẩn hóa phiên bản URL (khi đã quyết định dứt khoát).
5.3. Ngoại lệ: noindex, 404/410, và xử lý tham số
Noindex phù hợp khi trang hữu ích cho người dùng nội bộ nhưng không muốn xuất hiện trên tìm kiếm (ví dụ trang kết quả lọc nội bộ), tuy nhiên vẫn cần cân nhắc crawl budget.
404/410 phù hợp khi nội dung không còn và không có trang thay thế tương đương; tránh redirect “bừa” về trang không liên quan.
Bản đầy đủ của mục này có thêm: bảng 4 dòng (cột: Phương án, Mục tiêu, Khi nên dùng, Rủi ro thường gặp, Tín hiệu đi kèm nên đồng bộ). Xem bản đầy đủ
6. Mapping keyword → URL: quy trình, mẫu bảng và quản trị thay đổi
Mapping keyword sang URL là việc gán mỗi cluster truy vấn vào một primary URL và ghi rõ các URL phụ, để tránh nhiều đội cùng tạo trang cho một mục tiêu. Quy trình tối thiểu có năm bước: gom truy vấn rồi phân cluster theo intent, chọn primary URL, liệt kê URL đang đụng nhau, quyết định tách hay gộp, và chốt tín hiệu kỹ thuật cùng sitemap. Mẫu bảng gồm cột cluster, intent chính, primary URL, URL phụ và hành động chống trùng lặp. Quản trị thay đổi là ghi change log mỗi lần đổi primary URL.
Làm theo hướng dẫn từng bước thì dễ, biết vì sao các bước xếp theo thứ tự đó mới khó. Khóa Học SEO đi vào phần lý do đằng sau thứ tự.
Mapping keyword → URL là việc gán mỗi cluster truy vấn vào một URL “chủ” (primary URL) và quy định rõ URL phụ (supporting URLs) để tránh nhiều đội tạo nhiều trang cho cùng mục tiêu.
Trong vận hành, mapping là “hợp đồng” giữa SEO-Content-Dev: ai tạo trang gì, nằm ở đâu, và khi nào cần redirect/canonical.
6.1. Quy trình tối thiểu (Junior SEO làm được ngay)
Bước 1: gom danh sách truy vấn, phân cluster theo intent; Bước 2: chọn primary URL cho mỗi cluster; Bước 3: liệt kê URL hiện có đang “đụng nhau”.
Bước 4: quyết định tách/gộp; Bước 5: chốt tín hiệu kỹ thuật (redirect/canonical/internal links) và cập nhật sitemap.
6.2. Quy tắc đặt “primary URL”
Primary URL nên là trang có khả năng đáp ứng intent chính đầy đủ hơn các trang cùng cluster, có liên kết nội bộ mạnh và dễ mở rộng nội dung theo thời gian.
Nếu có nhiều trang tương tự, ưu tiên trang có nội dung đầy đủ hơn, lịch sử hiệu suất tốt hơn, và ít phụ thuộc tham số URL.
6.3. Quản trị thay đổi (change log)
Khi đổi primary URL hoặc hợp nhất trang, cần ghi nhận ngày thay đổi, loại thay đổi (301/canonical/gộp nội dung), và danh sách URL bị ảnh hưởng.
Change log giúp giải thích biến động performance và tránh “tái tạo” cannibalization trong các đợt viết nội dung sau.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Cluster / Chủ đề, Intent chính, Primary URL (được phép target), URL phụ (supporting), Hành động chống trùng lặp). Xem bản đầy đủ
7. Theo dõi trùng lặp và phát hiện cannibalization
Theo dõi trùng lặp và phát hiện cannibalization nên dựa trên dữ liệu, không dựa cảm giác: query nào kéo nhiều URL, URL nào được Google chọn canonical, và nhóm trang nào có title hay outline quá giống nhau. Cách làm phổ biến là ghép Google Search Console, gồm Performance và URL Inspection, với crawl nội bộ và rà internal links cùng sitemap. Chu kỳ đề xuất: website nhỏ soát theo tháng, website lớn hoặc có faceted navigation thì soát theo tuần cho nhóm URL nhạy cảm.
Cách làm phổ biến là kết hợp Google Search Console (Performance + URL Inspection) với crawl nội bộ và kiểm tra internal links/sitemap.
7.1. Dấu hiệu trong Google Search Console
Trong báo cáo Performance, cùng một query có impressions/clicks phân bổ cho nhiều URL (đặc biệt khi các URL thay phiên nhau tăng/giảm).
Trong URL Inspection, “Google-selected canonical” khác “User-declared canonical” là tín hiệu cần rà soát tín hiệu hợp nhất.
7.2. Dấu hiệu khi crawl site
Nhiều trang có title/H1/outline tương tự, hoặc nhiều URL chỉ khác tham số/sort/filter nhưng index được.
Nhiều redirect chain hoặc canonical trỏ vòng/không nhất quán cũng làm tăng rủi ro Google chọn canonical ngoài ý muốn.
7.3. Chu kỳ theo dõi đề xuất
Website nhỏ: rà soát theo tháng; website lớn hoặc có faceted navigation: theo tuần cho nhóm URL nhạy cảm (category/filter).
Khi có đợt cập nhật nội dung lớn hoặc đổi URL, tăng tần suất kiểm tra trong 2-4 tuần sau triển khai để bắt lỗi sớm.
Bản đầy đủ của mục này có thêm: bảng 4 dòng (cột: Cách theo dõi, Dữ liệu đầu vào, Phát hiện gì, Hành động tiếp theo). Xem bản đầy đủ
8. Cách thực hiện theo từng task (làm được ngay)
Cách thực hiện theo từng task biến các khái niệm thành checklist thao tác, hợp cho Junior SEO phối hợp với Content và Dev, làm được ngay trong tuần. Task A xử lý một truy vấn lai intent: chụp SERP top 10, chốt intent chính, quyết định hub hay spoke, rồi viết brief. Task B sửa cannibalization cho một cluster: xác định primary URL, chọn gộp bằng 301 hay giữ bằng canonical, đồng bộ internal links cùng sitemap. Task C chuẩn hóa URL sau khi gộp và kiểm lại bằng URL Inspection.
Mỗi task có đầu vào-đầu ra rõ ràng để dễ nghiệm thu, tránh triển khai “nửa vời” khiến tín hiệu mâu thuẫn.
8.1. Task A: Xử lý 1 truy vấn lai intent (chọn 1 trang hay nhiều trang)
Bước 1: chụp SERP top 10 và phân loại intent theo loại trang; Bước 2: chọn intent chính theo đa số và mục tiêu kinh doanh.
Bước 3: quyết định “hub đa-intent” hay “tách spoke”; Bước 4: viết content brief và cập nhật keyword → URL map.
8.2. Task B: Sửa cannibalization cho 1 cluster đang có nhiều URL
Bước 1: xác định primary URL; Bước 2: so nội dung để quyết định gộp (301) hay giữ (canonical/hub-spoke).
Bước 3: đồng bộ internal links + sitemap + canonical; Bước 4: theo dõi lại trong GSC theo chu kỳ.
8.3. Task C: Chuẩn hóa URL (canonical/redirect) sau khi gộp nội dung
Bước 1: tạo danh sách URL cũ → URL mới; Bước 2: triển khai 301 và kiểm tra không có chain/loop.
Bước 3: cập nhật internal links trỏ trực tiếp URL mới; Bước 4: kiểm tra URL Inspection để xác nhận canonical.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Task, Đầu vào, Đầu ra (deliverable), Ai phối hợp, Tiêu chí hoàn thành). Xem bản đầy đủ
9. Checklist triển khai và checklist kiểm tra
Checklist triển khai lo phần làm đủ tín hiệu khi tách hay gộp trang, để khỏi chỉ sửa nội dung mà bỏ quên internal links, sitemap hoặc redirect chain. Nó gồm xác định cluster và intent, chốt primary URL, cập nhật bản đồ keyword sang URL, triển khai 301 hoặc canonical, đồng bộ anchor, sitemap, breadcrumb và ghi change log. Checklist kiểm tra chạy sau đó, soi HTTP status, so user-declared canonical với google-selected canonical trong URL Inspection, xem Performance của query quan trọng, rồi crawl lại để đo title cùng duplicate similarity.
Checklist kiểm tra giúp xác nhận Google nhận đúng tín hiệu (canonical/redirect/index) và phát hiện sớm trường hợp Google chọn canonical khác.
9.1. Checklist triển khai (task checklist)
Checklist này liệt kê các task khi xử lý một cluster. Trước hết xác định cluster cùng intent chính và phụ, kèm bằng chứng từ SERP. Rồi chốt primary URL cho cluster và cập nhật bản đồ keyword sang URL. Nếu chọn gộp thì hợp nhất nội dung vào primary URL mà không làm mất phần hữu ích. Làm đủ rồi mới đo lại.
Bản đầy đủ của mục này có thêm: bảng 4 dòng (cột: Hạng mục, Triển khai, Kiểm tra, Công cụ gợi ý), 2 danh sách (tổng 15 dòng). Xem bản đầy đủ
9.2. Checklist kiểm tra (verification checklist)
Checklist này chạy sau khi đã triển khai, để xác nhận mọi thứ đúng như thiết kế. Kiểm HTTP status, tức 200 và 301 có đúng thiết kế không, có bị chain hay loop không. Kiểm trong GSC URL Inspection xem user-declared canonical và google-selected canonical có khớp nhau không. Kiểm GSC Performance xem query quan trọng có giảm sâu không.
10. Lỗi thường gặp và hiểu lầm thường có
Lỗi thường gặp và hiểu lầm thường có khi xử lý cannibalization ít khi đến từ viết dở, mà đến từ quyết định cấu trúc và tín hiệu kỹ thuật không nhất quán. Lỗi hay thấy là dùng canonical thay cho redirect sau khi đã gộp trang, tạo redirect chain, để internal links trỏ lung tung, hoặc viết hai ba bài tổng quan giống nhau. Hiểu lầm hay thấy là tin rằng duplicate content bị phạt, và tin rằng chỉ cần đặt canonical là xong.
Phần này liệt kê lỗi và hiểu lầm phổ biến để tránh “tối ưu sai chỗ” hoặc tạo thêm trùng lặp trong quá trình sửa.
10.1. Lỗi thường gặp
Lỗi điển hình gồm: dùng canonical để thay cho redirect khi đã gộp trang, tạo redirect chain, hoặc để internal links trỏ lung tung giữa các phiên bản URL.
Với truy vấn lai intent, lỗi thường là tạo 2-3 bài “tổng quan” giống nhau thay vì thiết kế hub-spoke có phạm vi rõ.
10.2. Hiểu lầm thường có (hoặc thao túng)
Hiểu lầm 1: “Duplicate content là bị phạt” → thực tế thường là Google chọn một phiên bản để hiển thị; vấn đề là bạn không kiểm soát được phiên bản đó.
Hiểu lầm 2: “Chỉ cần đặt canonical là xong” → nếu tín hiệu khác mâu thuẫn, Google vẫn có thể chọn canonical khác.
Bản đầy đủ của mục này có thêm: bảng 5 dòng (cột: Lỗi/hiểu lầm, Hậu quả, Cách khắc phục, Kiểm tra lại bằng). Xem bản đầy đủ
11. Ví dụ thực tế (3 kịch bản phổ biến)
Ba kịch bản phổ biến dưới đây mô phỏng tình huống thường gặp trên website nội dung hay dịch vụ. Kịch bản 1 là hai bài blog cùng giải thích một khái niệm, trùng outline, nên gộp rồi 301 bài còn lại. Kịch bản 2 là blog hướng dẫn tranh chỗ với landing dịch vụ do query lai intent, nên giữ hai trang nếu SERP chia rõ. Kịch bản 3 là category bị nhân bản do filter, nên chốt URL chuẩn làm canonical và kiểm soát index của biến thể.
Mục tiêu là chỉ ra cách chọn tách/gộp và chọn canonical/redirect theo từng bối cảnh, thay vì áp dụng một công thức cho mọi trường hợp.
11.1. Kịch bản 1: 2 bài blog cùng “định nghĩa” (trùng outline)
Tình huống: /canonical-la-gi/ và /the-canonical-url-la-gi/ cùng giải thích khái niệm, khác vài ví dụ.
Giải pháp điển hình: gộp phần nội dung đầy đủ hơn vào 1 bài, 301 bài còn lại về bài chuẩn, cập nhật internal links.
11.2. Kịch bản 2: Blog hướng dẫn vs landing dịch vụ (lai intent)
Tình huống: query “audit SEO” vừa có intent học cách làm, vừa có intent thuê dịch vụ; website có /audit-seo/ (dịch vụ) và /huong-dan-audit-seo/ (how-to).
Giải pháp điển hình: giữ 2 trang nếu SERP chia rõ; tạo hub hoặc internal link điều hướng theo intent, tránh 2 trang viết giống nhau.
11.3. Kịch bản 3: Category bị nhân bản do filter/sort
Tình huống: /ao-khoac/ có thêm /ao-khoac?color=den&sort=price... và các biến thể bị index, tạo nhiều URL gần như giống nhau.
Giải pháp điển hình: chốt URL chuẩn (category) làm canonical, gắn rel="canonical" từ biến thể về category (Google không khuyên dùng noindex để chọn canonical trong cùng site), và hạn chế internal links tới biến thể không cần index.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Kịch bản, Vấn đề, Quyết định tách/gộp, Canonical/Redirect, Tín hiệu bổ sung). Xem bản đầy đủ
12. Kết quả kỳ vọng đo lường và reporting
Kết quả kỳ vọng đo lường và reporting cho việc sửa cannibalization cần KPI rõ, không đánh giá bằng cảm giác. Mục tiêu không chỉ là giảm số URL cạnh tranh, mà còn là tăng ổn định hiển thị cho URL chủ và cải thiện CTR hợp intent. Reporting nên trình bày theo cụm, tức theo cluster, vì đây là vấn đề cấp cụm chứ không phải của từng URL rời rạc. Bốn nhóm chỉ số gồm phân tán URL, canonical Google chọn, hiển thị cùng click, và chuyển đổi.
Số liệu quanh “Kết quả kỳ vọng đo lường và reporting” thường nhiều nhưng ít chỉ số thật sự dùng được để ra quyết định. Khóa Học SEO Master đi vào phần chọn chỉ số.
“Sửa cannibalization” cần KPI rõ ràng để tránh đánh giá bằng cảm giác: mục tiêu không chỉ là giảm số URL cạnh tranh, mà còn là tăng ổn định hiển thị cho URL chủ và cải thiện CTR/traffic phù hợp intent.
Reporting nên trình bày theo cụm (cluster) thay vì theo từng URL rời rạc, vì cannibalization là vấn đề cấp cụm.
12.1. KPI gợi ý theo cluster
Theo dõi: số lượng URL/cluster xuất hiện cho nhóm query mục tiêu, tỷ lệ impressions tập trung vào primary URL, và biến động vị trí trung bình theo thời gian.
Nếu có mục tiêu chuyển đổi, theo dõi thêm CTR theo trang đích và conversion rate theo intent (informational vs transactional).
12.2. Mẫu báo cáo ngắn (1 trang)
Một báo cáo thực dụng gồm: (1) tình trạng trước-sau, (2) hành động đã làm (301/canonical/gộp nội dung), (3) tác động, (4) việc cần làm tiếp theo.
Quan trọng: luôn ghi change log để giải thích biến động và tránh “đổ lỗi thuật toán” khi vấn đề là tín hiệu mâu thuẫn.
Bản đầy đủ của mục này có thêm: bảng 4 dòng (cột: Nhóm chỉ số, Đo cái gì, Kỳ vọng sau xử lý, Nguồn dữ liệu). Xem bản đầy đủ
13. Ứng dụng thực tế trong công việc (Junior SEO)
Trong môi trường đi làm, Junior SEO thường nhận task “tối ưu bài X” hoặc “tăng traffic chủ đề Y”, nhưng gốc rễ đôi khi là cannibalization và intent chưa chốt.
Ứng dụng thực tế là biến vấn đề thành quy trình: SERP analysis → keyword cluster → mapping → tách/gộp → tín hiệu kỹ thuật → theo dõi.
13.1. Khi nhận brief “viết thêm bài cho từ khóa đang có bài rồi”
Không viết ngay; trước tiên kiểm tra keyword → URL map (nếu chưa có thì tạo), xem từ khóa đó thuộc cluster nào và primary URL là gì.
Nếu cần viết mới, yêu cầu scope khác rõ ràng (spoke) và liên kết về hub, tránh viết lại “tổng quan” lần nữa.
13.2. Khi thấy thứ hạng “nhảy URL” theo tuần
Kiểm tra GSC: query đó đang phân phối impressions cho những URL nào; sau đó crawl nhanh để xem mức độ trùng title/H1/nội dung.
Ưu tiên chốt primary URL và đồng bộ internal links/sitemap/canonical; chỉ dùng redirect khi quyết định hợp nhất dứt khoát.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Tình huống công việc, Việc cần làm (ưu tiên), Đầu ra, Thời gian tham chiếu). Xem bản đầy đủ
14. Kinh nghiệm thực tế (ngắn gọn)
Trong nhiều dự án, “đặt canonical” chỉ hiệu quả khi các tín hiệu khác không tự mâu thuẫn: internal links, sitemap, cấu trúc điều hướng và chất lượng nội dung phải cùng hướng về URL chuẩn.
Với truy vấn lai intent, cách bền vững thường là thiết kế hub-spoke (một trang trung tâm + trang phụ theo use-case), thay vì nhân bản nhiều bài “tổng quan”.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Bài học, Dấu hiệu nhận biết, Cách làm gợi ý, Lợi ích). Xem bản đầy đủ
15. Lời kết
Lời kết của bài này gói vào một ý: xử lý truy vấn lai intent và cannibalization không chỉ là tối ưu onpage, mà là bài toán quy hoạch. Bạn chốt intent, chốt URL chủ, rồi đồng bộ tín hiệu kỹ thuật, nội dung và liên kết nội bộ. Với Junior SEO, thứ đáng xây là thói quen chạy theo quy trình: SERP, cluster, mapping, tách hay gộp, canonical hay redirect, rồi theo dõi.
Với Junior SEO, ưu tiên xây được thói quen làm việc theo quy trình (SERP → cluster → mapping → tách/gộp → canonical/redirect → theo dõi) sẽ giúp giảm lỗi và tăng tính lặp lại của kết quả.
Bản đầy đủ của mục này có thêm: bảng 3 dòng (cột: Điểm cần nhớ, Tóm tắt, Áp dụng ngay). Xem bản đầy đủ
16. FAQ (10 câu hỏi thường gặp)
FAQ gom 10 câu hỏi thường gặp khi xử lý mixed intent và cannibalization, trả lời ngắn và dùng được ngay. Các câu ở đây làm rõ truy vấn lai intent là gì, cannibalization có bị phạt không, khi nào nên gộp hai trang đang cạnh tranh, khi nào nên tách, canonical khác 301 redirect thế nào, vì sao Google vẫn chọn URL khác, website nhỏ có cần mapping keyword sang URL không, và theo dõi bằng Search Console ra sao. Mỗi câu trả lời kèm tiêu chí khi nào làm và kiểm lại bằng gì.
Mỗi câu trả lời ưu tiên tiêu chí vận hành: khi nào làm, làm như thế nào, và kiểm tra lại bằng gì.
Truy vấn “lai intent” là gì?
Truy vấn “lai intent” là truy vấn mà người dùng có thể có nhiều mục đích hợp lý, và SERP thường hiển thị nhiều loại trang để đáp ứng các mục đích đó.
Cách nhận biết nhanh là xem top 10 có pha trộn giữa bài hướng dẫn, bài so sánh, danh mục, landing... hay không.
Cannibalization có phải luôn xấu và “bị phạt” không?
Cannibalization không nhất thiết là “án phạt”, nhưng thường làm phân tán tín hiệu và khiến website khó ổn định một URL mạnh cho một cluster truy vấn.
Điểm cần xử lý là tạo sự nhất quán: một primary URL được ưu tiên bằng nội dung, internal links, sitemap và (khi phù hợp) canonical/redirect.
Khi nào nên gộp hai trang đang cạnh tranh?
Nên gộp khi hai trang có intent chính giống nhau và outline chồng lấp lớn, khiến người dùng không cần hai điểm đến khác nhau.
Sau khi gộp, thường triển khai 301 từ URL phụ về URL chuẩn và cập nhật internal links trỏ thẳng về URL chuẩn.
Khi nào nên tách trang thay vì gộp?
Nên tách khi intent khác nhau rõ rệt (ví dụ: “hướng dẫn” vs “mua/bảng giá”), hoặc khi SERP cho thấy hai dạng trang riêng biệt cùng có cơ hội xếp hạng.
Để tránh cannibalization, cần viết phạm vi (scope) rõ cho từng trang và liên kết nội bộ theo intent.
Canonical và 301 redirect khác nhau thế nào?
301 redirect chuyển người dùng và bot sang URL mới, phù hợp khi bạn muốn hợp nhất dứt khoát và không dùng URL cũ nữa.
Canonical là tín hiệu gợi ý URL ưu tiên khi nhiều URL có nội dung tương tự; URL phụ vẫn có thể truy cập.
Vì sao đặt canonical nhưng Google vẫn chọn URL khác?
Google có thể chọn canonical khác nếu thấy URL khác “hợp lý hơn” dựa trên nhiều tín hiệu như nội dung, liên kết nội bộ, sitemap, hoặc chất lượng tổng thể của trang.
Cách xử lý là đồng bộ toàn bộ tín hiệu về URL chuẩn, không chỉ đặt mỗi thẻ canonical.
Mapping keyword → URL có cần cho website nhỏ không?
Có. Website càng nhỏ càng dễ kiểm soát sớm, và mapping giúp tránh tạo trang trùng khi nhiều người cùng làm nội dung.
Chỉ cần một bảng đơn giản: cluster, intent, primary URL, URL phụ, và quy tắc không tạo thêm trang “tổng quan”.
Theo dõi cannibalization bằng Google Search Console như thế nào?
Trong Performance, lọc theo query và xem tab Pages để biết query đó đang phân phối impressions/clicks cho những URL nào.
Nếu một query có nhiều URL thay phiên nhau tăng/giảm, đó là tín hiệu cần chốt primary URL và đồng bộ các tín hiệu hợp nhất.
Có nên noindex các trang “trùng” không?
Noindex phù hợp khi trang vẫn cần cho người dùng nội bộ nhưng không muốn xuất hiện trên tìm kiếm (ví dụ trang lọc nội bộ), tuy nhiên vẫn cần cân nhắc crawl và trải nghiệm.
Nếu mục tiêu là hợp nhất dứt khoát và có trang thay thế tương đương, 301 thường là lựa chọn rõ ràng hơn.
Sau khi gộp trang, cần theo dõi bao lâu để thấy ổn định?
Không có mốc cố định cho mọi website; thực hành thường là theo dõi theo chu kỳ (tuần/tháng) dựa trên tốc độ crawl/index và mức độ thay đổi.
Điểm quan trọng là kiểm tra sớm: status redirect, canonical trong URL Inspection, và phân phối URL trong Performance theo query mục tiêu.
17. Nguồn tham khảo
Dưới đây là các tài liệu chính thức/ưu tiên từ Google Search Central và Google Help liên quan đến canonical, redirect, di chuyển URL và xử lý trùng lặp:
- Google Search Central: Consolidate duplicate URLs (canonical)
- Google Search Central: Canonicalization troubleshooting
- Google Search Central: Redirects and Google Search
- Google Search Central Blog: Demystifying the “duplicate content penalty”
- Google Search Central: Site move with URL changes
- Google Search Console Help: Change of Address tool
- Google Search Central: Link best practices
Bước tiếp theo
Muốn tự làm được việc này trên website của bạn?
SEO Master hướng dẫn làm SEO trong 24 buổi, từ tư duy nền tảng tới triển khai và đo lường trên website thật.
Tài liệu trả phí
Bản đầy đủ: Xử lý truy vấn lai intent & tránh cannibalization: tách/gộp, canonical vs redirect
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 8.786 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 14 bước, bảng lỗi, mẫu, nghiệm thu (5 bảng)
- PDF: 23 trang, tải về
- Excel: 20 bảng và 29 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
Định nghĩaCannibalization là hiện tượng nhiều URL trên cùng một website cạnh tranh cho cùng một cụm truy vấn, làm tín hiệu bị phân tán, và xử lý đúng giúp bạn ổn định thứ hạng cho một primary URL.
Cách xử lý truy vấn lai intent và tránh cannibalization
Các bước giúp bạn chốt intent, gán mỗi cluster về một primary URL, chọn đúng 301 hay canonical và theo dõi để thứ hạng ổn định hơn.
- Phân tích SERP top 10Chụp SERP top 10, phân loại kết quả theo loại trang rồi chọn intent chính theo đa số và mục tiêu kinh doanh.
- Gom truy vấn thành clusterGom danh sách truy vấn và phân cluster theo intent, để mỗi nhóm có quan hệ ngữ nghĩa rõ và có thể phục vụ bằng một URL trung tâm.
- Chọn primary URL cho clusterChọn trang đáp ứng intent chính đầy đủ hơn, có liên kết nội bộ mạnh, lịch sử hiệu suất tốt hơn và ít phụ thuộc tham số URL.
- Quyết định tách hay gộpGộp khi intent chính giống nhau và outline chồng lấp, tách khi intent khác rõ như hướng dẫn với bảng giá, hoặc dùng hub cùng spoke cho truy vấn lai intent.
- Chốt 301 hoặc canonicalDùng 301 khi hợp nhất dứt khoát và kiểm tra không có chain hay loop, dùng canonical khi cần giữ nhiều URL rất giống nhau.
- Đồng bộ tín hiệu nội bộCập nhật internal links trỏ thẳng về primary URL, cập nhật sitemap, bản đồ keyword sang URL và ghi change log cho mỗi lần thay đổi.
- Theo dõi lại trong Search ConsoleĐối chiếu user-declared canonical với google-selected canonical trong URL Inspection, xem query quan trọng trong Performance và tăng tần suất kiểm tra trong 2-4 tuần sau triển khai.
Câu hỏi thường gặp về Cannibalization
Giải đáp trực tiếp các câu hỏi thường gặp về Cannibalization dựa trên dữ liệu triển khai thực tế, quy trình kiểm thử kỹ thuật và kinh nghiệm thực chiến trên website thật để tối ưu hiệu quả tìm kiếm.
Vì sao thứ hạng của một từ khóa cứ nhảy qua lại giữa các URL theo tuần?
Thứ hạng nhảy URL thường là dấu hiệu cannibalization: nhiều trang có nội dung hay ý định chồng lấp cùng cạnh tranh một cụm truy vấn. Bạn kiểm tra GSC xem query đó phân phối impressions cho những URL nào, crawl lại để xem mức trùng title, H1 và nội dung, rồi chốt primary URL và đồng bộ internal links, sitemap, canonical.
Được giao viết thêm bài cho từ khóa đã có bài thì nên làm gì trước?
Bạn chưa viết ngay. Trước tiên kiểm tra bản đồ keyword sang URL, nếu chưa có thì tạo, rồi xem từ khóa đó thuộc cluster nào và primary URL là gì. Nếu vẫn cần bài mới, yêu cầu scope khác rõ ràng dạng spoke, liên kết về hub, và không viết lại một bài tổng quan nữa.
Sai lầm nào hay gặp khi xử lý trang trùng sau khi đã gộp nội dung?
Sai lầm điển hình là dùng canonical cho trang đã gộp, trong khi lúc hợp nhất dứt khoát nên dùng 301. Các lỗi đi kèm là tạo redirect chain, để internal links trỏ lung tung giữa các phiên bản URL, hoặc chỉ sửa nội dung mà quên cập nhật sitemap.
Vì sao một truy vấn lai intent dễ sinh ra nhiều trang na ná nhau trên site?
Truy vấn lai intent dễ khiến mỗi team viết một kiểu: bài định nghĩa, bài hướng dẫn, landing bán hàng, mà không có quy ước URL chính. Khi internal links, sitemap, canonical và redirect không thống nhất, Google có thể chọn URL khác với ý muốn của bạn hoặc đổi URL hiển thị theo thời gian.
Chấm điểm intent từ SERP top 10 theo cách thực dụng như thế nào?
Bạn gán điểm intent dựa trên tỷ lệ loại trang trong top 10, ví dụ 6/10 là guide thì intent informational mạnh. Nếu intent phụ vẫn chiếm tỷ lệ đáng kể, khoảng 3-4/10, bạn cân nhắc một trang đa intent hoặc cấu trúc hub-spoke.
Cấu trúc hub-spoke giúp gì khi xử lý truy vấn lai intent?
Hub-spoke giúp phủ nhiều nhu cầu mà không sinh trang na ná nhau. Trang hub phục vụ intent chính và liên kết sang các trang spoke phục vụ intent phụ chuyên sâu. Cấu trúc này chỉ hiệu quả khi internal link và anchor text nhất quán, và ở mức nâng cao có thể thêm breadcrumb cùng schema.
Nên rà soát cannibalization bao lâu một lần cho từng loại website?
Website nhỏ rà soát theo tháng. Website lớn hoặc có faceted navigation thì rà theo tuần cho nhóm URL nhạy cảm như category và filter. Khi có đợt cập nhật nội dung lớn hoặc đổi URL, bạn tăng tần suất kiểm tra trong 2-4 tuần sau triển khai để bắt lỗi sớm.
Báo cáo sau khi sửa cannibalization nên theo dõi những chỉ số nào?
Bạn báo cáo theo cluster với bốn nhóm chỉ số: phân tán URL, canonical Google chọn, hiển thị cùng click, và chuyển đổi. Cụ thể là số URL xuất hiện cho nhóm query mục tiêu, tỷ lệ impressions tập trung vào primary URL, biến động vị trí trung bình, CTR theo trang đích và conversion rate theo intent.
Cannibalization trong SEO là gì và nhận biết bằng cách nào?
Cannibalization trong SEO là hiện tượng nhiều URL trên cùng một website cạnh tranh cho cùng một cụm truy vấn, làm tín hiệu phân tán và thứ hạng khó ổn định. Cách nhận biết là xem Google Search Console có query nào chia impressions cho nhiều URL thay phiên tăng giảm, hoặc crawl thấy title và outline trùng nhau.
Chỉ cần đặt thẻ canonical là xử lý xong cannibalization không?
Đặt thẻ canonical chưa đủ để xử lý xong cannibalization. Google có thể chọn canonical khác nếu các tín hiệu khác mâu thuẫn. Muốn canonical có hiệu quả, internal links, sitemap, cấu trúc điều hướng và chất lượng nội dung phải cùng hướng về URL chuẩn, rồi bạn kiểm tra lại trong URL Inspection.
Mapping keyword sang URL là gì và nên bắt đầu từ đâu?
Mapping keyword sang URL là việc gán mỗi cluster truy vấn vào một primary URL và ghi rõ các URL phụ, để nhiều đội không tạo trang cho cùng một mục tiêu. Bắt đầu mapping keyword sang URL bằng việc gom truy vấn, phân cluster theo intent, chọn primary URL rồi liệt kê các URL đang đụng nhau.
Lai intent khác cannibalization thế nào trong SEO?
Lai intent là tình huống một truy vấn có hai ý định hợp lý trở lên và SERP hiển thị nhiều loại trang. Cannibalization là khi nhiều URL trên cùng site có nội dung hay ý định chồng lấp và cùng cạnh tranh một tập truy vấn. Lai intent nằm ở truy vấn, còn cannibalization nằm ở website.
Làm tiếp trên chính website của bạn
Chọn theo điều bạn đang cần: người soi website, nền tảng để tự làm, hay người kèm tới nơi.
Phân tích SEO và GEO Online
Tìm đúng chỗ website đang nghẽn, bàn giao thứ tự sửa và bản đồ nội dung theo DLN™. Học tiếp Mentor thì phí này được trừ vào học phí.
Xem phạm vi phân tíchKhóa học SEO cơ bản Online
6 buổi online về Technical và On-page, đủ nền tảng để tự rà và sửa website của bạn.
Xem lộ trình họcMentor SEO 1 kèm 1 Online
12 buổi trong 4 tuần, làm trực tiếp trên website của bạn cùng Danh Nolan.
Xem cách kèm