
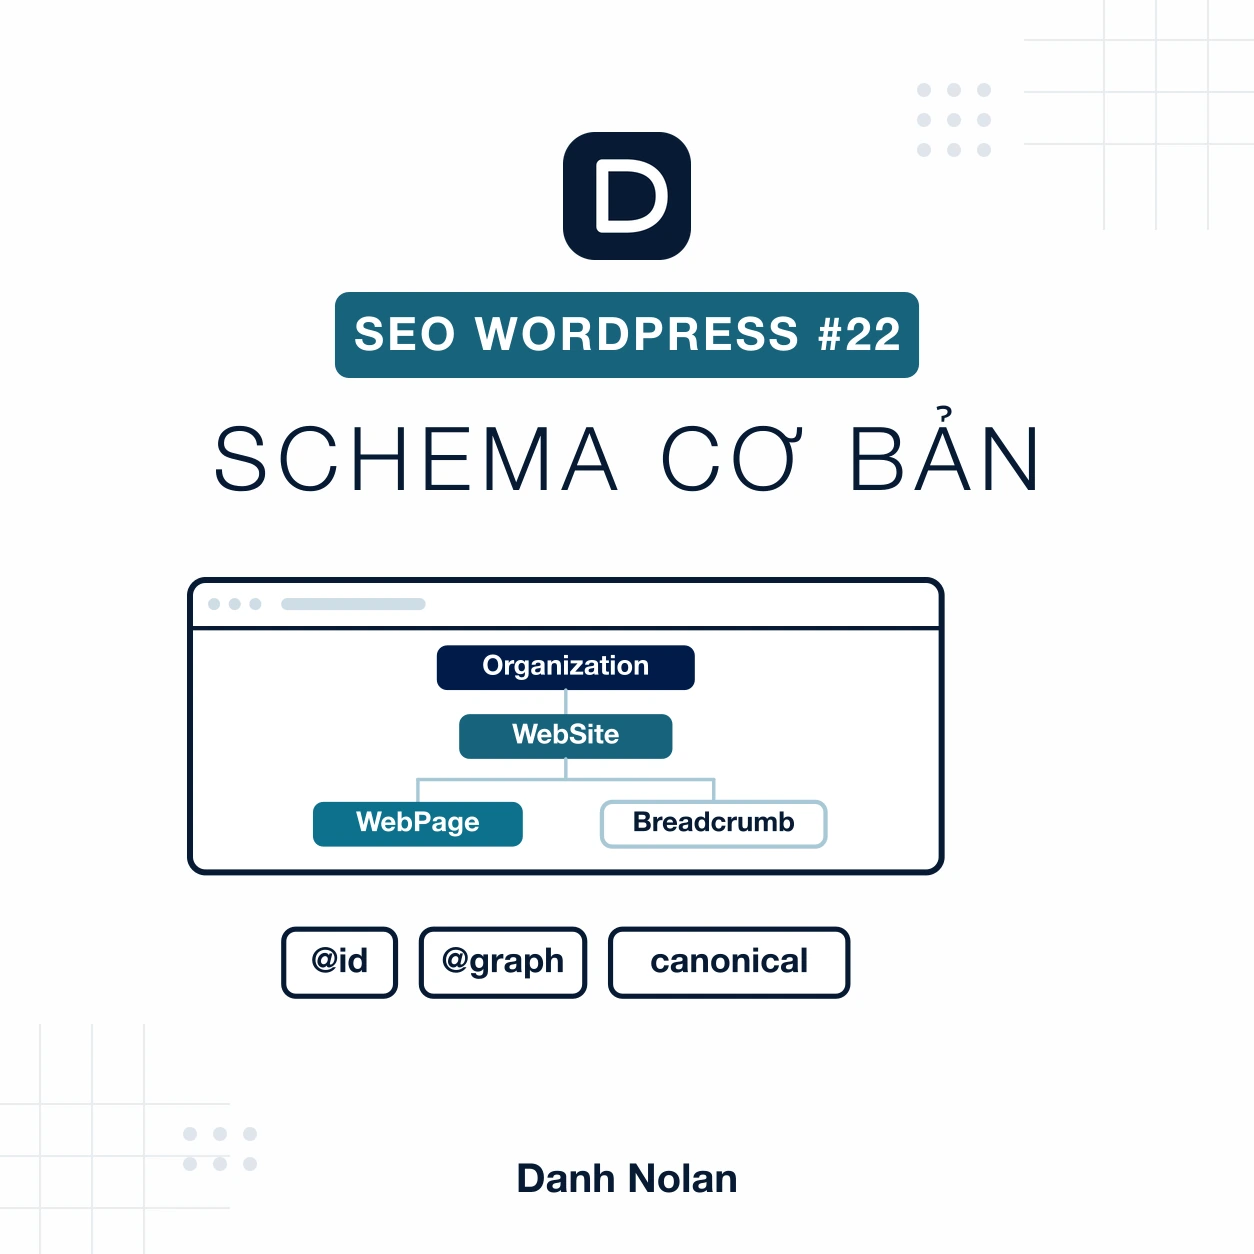
Schema cơ bản là bộ node mà mọi website đều nên có dù bán gì hay viết gì: chủ sở hữu website, chính website, từng trang, và đường dẫn phân cấp tới trang đó. Bài #22 chuyển tiêu chí 184-193 thành các bước khai Organization, WebSite, WebPage, BreadcrumbList, đặt @id ổn định, khớp URL với canonical, nối thực thể bằng @graph và dọn schema trùng.
Bài dành cho SEOer, người quản trị WordPress và đội phát triển cần một khối JSON-LD nhất quán trên toàn website. Mỗi tiêu chí đi kèm cách kiểm bằng công cụ, lỗi thường gặp, và ranh giới giữa việc schema thật sự làm được với việc nhiều người tưởng nó làm được.
1. Schema cơ bản là gì và mọi website cần những node nào?
Schema cơ bản là bốn node nền cùng cách nối chúng lại: một node cho chủ sở hữu website, một node cho website, một node cho từng trang, và một node cho đường dẫn phân cấp dẫn tới trang đó. Bốn node này không phụ thuộc ngành nghề, nên chúng là phần khai được ngay trước khi bàn tới các loại schema riêng của từng loại nội dung.
Việc mà schema thật sự làm là xóa mơ hồ. Trên trang, tên thương hiệu chỉ là một dòng chữ, và máy phải suy ra đó là tên công ty, tên tác giả hay tên sản phẩm. Khi khai thành node có @id, cùng một thực thể được nhắc ở mọi trang đều trỏ về đúng một địa chỉ, nên máy đọc xong biết website này thuộc về ai, gồm những trang nào, và trang đang đọc nằm ở đâu trong cấu trúc.
Cần nói rõ ngay điều schema KHÔNG làm: nó không phải tín hiệu xếp hạng. Google không nâng vị trí vì một trang có JSON-LD. Nó làm hai việc khác: giúp bộ máy hiểu nội dung để đủ điều kiện hiện kết quả dạng đặc biệt, và cung cấp một bản dữ liệu có cấu trúc cho những nơi đọc đồ thị thay vì đọc chữ.
Đầu ra cần có: một khối JSON-LD duy nhất cho mỗi trang, trong đó bốn node nền nối nhau bằng @id, mọi URL khớp canonical, và không thực thể nào bị khai hai lần. Nền của chủ đề nằm ở mục tra cứu Schema Markup.
2. Checklist Schema cơ bản: 10 tiêu chí từ 184 đến 193
Mười tiêu chí dưới đây chia thành hai nửa rõ rệt: bốn tiêu chí đầu là khai cái gì, sáu tiêu chí sau là khai cho đúng và cho nhất quán. Nửa sau thường bị bỏ qua, và đó cũng là nơi sinh ra phần lớn lỗi thật, vì thêm một node thì dễ còn giữ một đồ thị không mâu thuẫn thì khó.
| Mã | Tiêu chí | Bằng chứng đạt | Trọng số |
|---|---|---|---|
| 184 | Schema chủ sở hữu website | Một node Organization hoặc Person, dữ liệu thật | Quan trọng |
| 185 | Schema WebSite | Có name, url, publisher, inLanguage khi phù hợp | Quan trọng |
| 186 | Schema BreadcrumbList | Khớp breadcrumb đang hiển thị, position đúng | Quan trọng |
| 187 | Schema WebPage | Mỗi trang một node, có isPartOf trỏ về WebSite | Quan trọng |
| 188 | @id duy nhất và ổn định | Cùng thực thể dùng lại đúng một @id toàn website | Quan trọng |
| 189 | URL Schema khớp canonical | URL tuyệt đối HTTPS, đúng phiên bản đã chọn | Bắt buộc |
| 190 | Liên kết bằng @graph | Node trỏ nhau bằng @id, không rời rạc | Quan trọng |
| 191 | Dữ liệu thực thể nhất quán | Tên, logo, liên hệ giống nhau ở mọi trang | Quan trọng |
| 192 | Schema khớp nội dung hiển thị | Không khai thứ người đọc không thấy trên trang | Bắt buộc |
| 193 | Không trùng hoặc mâu thuẫn | Một Organization, một WebSite trên mỗi trang | Bắt buộc |
Hai công cụ chia nhau hai việc khác nhau và không thay thế nhau. Schema Markup Validator kiểm cú pháp và từ vựng schema.org, tức trả lời câu khai có hợp lệ không. Rich Results Test chỉ kiểm những loại Google dùng cho kết quả đặc biệt, tức trả lời câu khai này có đủ điều kiện hiện gì không.
Vì vậy một đồ thị hoàn toàn đúng vẫn có thể ra thông báo không tìm thấy loại nào đủ điều kiện trong Rich Results Test, và đó KHÔNG phải lỗi. Bốn node nền của bài này chỉ có BreadcrumbList là loại Google dùng cho kết quả đặc biệt; ba node còn lại phục vụ việc hiểu thực thể.
3. Tiêu chí 184: Schema chủ sở hữu website
Schema chủ sở hữu là node nói website này thuộc về ai: Organization hoặc một subtype phù hợp cho doanh nghiệp, còn website cá nhân thì dùng Person. Bốn trường cần đúng là tên, URL, logo và liên hệ, cộng thêm sameAs để nối thực thể này với các hồ sơ bên ngoài.
Chọn subtype thay vì Organization trần là thứ rẻ nhất có thể làm. Organization chỉ nói đây là một tổ chức, còn subtype nói tổ chức này làm gì, ví dụ EducationalOrganization cho nơi đào tạo hay LocalBusiness cho cơ sở có địa điểm phục vụ khách. Nhưng đừng khai LocalBusiness khi chưa có địa chỉ đầy đủ: thiếu số nhà và tên đường thì nó không đủ điều kiện cho kết quả địa phương, và chỉ còn là một nhãn khai suông.
Phần sameAs quan trọng hơn vẻ ngoài của nó, vì đó là chỗ duy nhất trong cả node có thứ bên ngoài xác nhận. Mọi trường khác đều là website tự nói về mình. Điều kiện kèm theo: chỉ khai hồ sơ đã được chủ sở hữu xác nhận. Một URL không phải của mình làm hỏng đúng việc mà sameAs sinh ra để làm.
Hai chỗ hay sai trên WordPress: tên thương hiệu trong schema lấy từ tên website trong cài đặt nên có khi là một tên miền chứ không phải tên thật, và logo lấy từ ảnh đại diện website nên có khi là một ảnh cắt vuông không đúng logo. Điều kiện nghiệm thu: đúng một node chủ sở hữu trên mỗi trang, tên là tên thật, logo là tệp logo, và mọi sameAs là hồ sơ đã xác nhận. Chi tiết nằm ở mục Organization và Local Schema cùng mục SameAs và Citation Schema.
4. Tiêu chí 185: Schema WebSite
Node WebSite mô tả chính website như một thực thể, gồm name, url, publisher trỏ về node chủ sở hữu, và inLanguage khi website có một ngôn ngữ chính rõ ràng. Nó là node mà mọi node WebPage sẽ trỏ về bằng isPartOf, nên nó là gốc của cây quan hệ trong đồ thị.
Điểm cần cập nhật so với nhiều hướng dẫn cũ: KHÔNG cần khai SearchAction nữa. Trước đây node đó dùng để xin hộp tìm kiếm trong kết quả của Google, nhưng Google đã ngừng tính năng hộp tìm kiếm sitelinks, nên khai nó bây giờ chỉ thêm một khối không ai đọc. Giữ lại cũng không gây lỗi, nhưng nó là dấu hiệu cấu hình schema chưa được soát lại.
Phân biệt WebSite với Organization là chỗ dễ lẫn. Organization là tổ chức, tồn tại cả khi không có website; WebSite là tập hợp trang tại một tên miền. Một tổ chức có thể có hai website, và hai website có thể cùng một publisher. Khai gộp hai thứ vào một node là mất khả năng nói câu đó.
Về name: dùng đúng tên thương hiệu, không dùng tên miền, và phải giống tên trong node chủ sở hữu. Nếu muốn giữ tên miền để máy nối được hai cách gọi, hãy đưa nó vào alternateName. Điều kiện nghiệm thu: đúng một node WebSite trên mỗi trang, publisher trỏ về đúng @id của node chủ sở hữu, và name giống nhau ở mọi trang.
6. Tiêu chí 187: Schema WebPage
Mỗi trang cần một node WebPage hoặc subtype phù hợp, với name, url, description, inLanguage và isPartOf phản ánh đúng trang đó. Đây là node hay bị thiếu nhất, vì nhiều cấu hình chỉ khai node của loại nội dung chính như Article hay Product rồi coi như xong.
Hậu quả của việc thiếu nó rất cụ thể: một URL không có node nào ở cấp trang là một URL không có tên trong đồ thị, không có mô tả, và không thuộc website nào. Nhóm trang hay lọt vào trạng thái đó là trang pháp lý, trang liên hệ, trang danh sách và trang phân trang, tức đúng nhóm không mang loại nội dung đặc biệt nào.
Về subtype, chọn khi nó nói thêm được điều gì: AboutPage cho trang giới thiệu, ContactPage cho trang liên hệ, CollectionPage cho trang danh sách, ItemPage cho trang một đối tượng. Khi không có subtype nào đúng, WebPage trần vẫn là câu trả lời đúng, và nó tốt hơn hẳn việc không khai gì.
Quan hệ với node nội dung chính cần rõ: trang có bài viết thì vẫn có cả hai node, WebPage cho trang và Article cho bài, nối nhau bằng mainEntityOfPage hoặc mainEntity. Gộp hai thứ là mất khả năng nói bài này được đăng ở trang này. Điều kiện nghiệm thu: mọi URL lập chỉ mục đều có một node cấp trang, và node đó có isPartOf trỏ về WebSite.
7. Tiêu chí 188: @id duy nhất và ổn định
Mỗi thực thể chính cần một @id tuyệt đối, duy nhất và ổn định, và cùng một thực thể phải dùng lại đúng @id đó trên toàn website. Đây là tiêu chí quyết định cả đồ thị: @id là cái tên mà máy dùng để nhận ra hai lần nhắc là cùng một thứ.
Quy ước đang phổ biến và nên theo: lấy URL tuyệt đối rồi thêm một mảnh sau dấu thăng cho thực thể không phải một trang, ví dụ đuôi organization cho tổ chức, website cho website, person cho người. Thực thể là một trang thì @id lấy đúng canonical của trang đó. Cách này cho @id vừa duy nhất vừa đọc lên hiểu ngay đang nói về ai.
Chữ ổn định quan trọng ngang chữ duy nhất. @id đổi theo thời gian là mọi tham chiếu cũ trỏ vào một địa chỉ không còn tồn tại, và với máy thì đó là một thực thể mới chứ không phải thực thể cũ đổi tên. Vì vậy đừng nhúng vào @id những thứ hay đổi như tên hiển thị, số phiên bản hay ngày.
Một bẫy đã đo được và rất khó thấy: hai node TRÙNG @id trong cùng một đồ thị. Bộ dựng thường loại node thứ hai, còn bộ đọc thì gộp hoặc lấy một trong hai, nên kết quả là một node biến mất lặng lẽ mà không công cụ nào báo lỗi. Trường hợp hay gặp: một mục và một section bọc nó cùng suy ra một mảnh giống nhau. Điều kiện nghiệm thu: không @id nào xuất hiện hai lần trong một đồ thị, và mỗi thực thể dùng cùng một @id ở mọi trang nhắc tới nó.
8. Tiêu chí 189: URL Schema khớp canonical
Các thuộc tính url, @id và mainEntityOfPage phải dùng URL tuyệt đối dạng HTTPS và khớp đúng canonical của trang, gồm cả việc có www hay không và có dấu gạch chéo cuối hay không. Đây là tiêu chí Bắt buộc vì nó là chỗ schema mâu thuẫn với chính trang chứa nó.
Hậu quả khi lệch: canonical nói trang chuẩn là một URL, schema nói thực thể này ở một URL khác, nên máy nhận hai địa chỉ cho một trang. Đó đúng là sự mơ hồ mà cả việc khai schema sinh ra để xóa, và nó tự tạo ra ngay trong cùng một tài liệu.
Bốn dạng lệch hay gặp, tất cả đều đo được: URL dạng http còn sót sau khi chuyển sang HTTPS; URL tương đối thay vì tuyệt đối; thiếu hoặc thừa dấu gạch chéo cuối so với canonical; và bản có www lẫn bản không www dùng lẫn trong cùng một đồ thị. Ba dạng đầu thường do cấu hình cũ, dạng cuối thường do một plugin lấy URL từ một nguồn khác với nguồn mà canonical dùng.
Cách kiểm trên toàn website: crawl bằng Screaming Frog, trích xuất canonical và các URL trong JSON-LD rồi so từng dòng. Với một trang thì mở mã nguồn và đọc hai chỗ cạnh nhau là thấy. Phần chọn một phiên bản chuẩn đã bàn ở bài #20 về HTTPS. Điều kiện nghiệm thu: 0 URL trong JSON-LD khác canonical của chính trang, và 0 URL tương đối hoặc dạng http.
9. Tiêu chí 190: Liên kết thực thể bằng @graph
Các node phải nối nhau bằng @id qua isPartOf, publisher, about hoặc mainEntity, và cùng nằm trong một @graph, thay vì tồn tại thành những khối rời rạc. Khác biệt giữa hai cách không phải hình thức: nối bằng tham chiếu là một đồ thị, còn để rời là nhiều mảnh mà máy phải tự đoán quan hệ.
Lý do cần nói bằng một ví dụ đo được: khi mỗi khối tự mang @context và tự khai lại tổ chức của mình, một trang có thể phát ra bốn node Organization và hai node WebSite. Với bộ đọc đó là bốn công ty trùng tên, tức đúng sự mơ hồ mà schema sinh ra để xóa. Cách chữa là @id ổn định cộng một @graph duy nhất, để node nhắc tới nhau bằng tham chiếu thay vì nhân bản.
Bộ nối tối thiểu cho bốn node nền: WebPage có isPartOf trỏ @id của WebSite; WebSite có publisher trỏ @id của Organization; node nội dung chính có mainEntityOfPage trỏ @id của WebPage; và BreadcrumbList đứng cùng graph. Bốn dòng đó là toàn bộ phần kết nối, và chúng biến bốn node rời thành một cấu trúc đọc được từ trên xuống.
Cách kiểm: đưa khối JSON-LD vào JSON-LD Playground và xem dạng đã làm phẳng. Mọi tham chiếu trỏ đúng thì các node hiện ra nối nhau; tham chiếu trỏ sai thì lộ ra ngay vì đầu bên kia không tồn tại. Điều kiện nghiệm thu: một khối @graph cho mỗi trang, mọi tham chiếu @id đều có đích trong cùng graph, và không node nào tự khai lại @context.
10. Tiêu chí 191: Dữ liệu thực thể nhất quán
Tên thương hiệu, logo, URL, số điện thoại, địa chỉ và sameAs trong schema phải giống nhau giữa các trang, và giống với thông tin doanh nghiệp công khai bên ngoài website. Nhất quán ở đây không phải yêu cầu hình thức: mỗi giá trị lệch là một lý do để máy nghĩ đang có hai thực thể khác nhau.
Hai chiều cần kiểm, và chiều thứ hai hay bị bỏ. Chiều trong website: mọi trang khai cùng một tên, cùng một logo, cùng một số điện thoại. Chiều ra ngoài: những giá trị đó khớp với hồ sơ mạng xã hội, hồ sơ doanh nghiệp và các nơi khác đang nhắc tới thương hiệu. Khai một số điện thoại trong schema khác số đang ghi trên trang liên hệ là tự tạo mâu thuẫn ở chỗ dễ thấy nhất.
Nguyên nhân gốc trên WordPress thường là dữ liệu nằm ở nhiều nơi: tên website trong cài đặt chung, tên thương hiệu trong cấu hình plugin SEO, và một dòng chữ viết tay trong footer của theme. Ba nguồn thì trôi khỏi nhau sau vài lần sửa. Cách chữa bền là chọn một nguồn duy nhất rồi để hai chỗ kia đọc từ đó.
Cách kiểm trên toàn website: crawl rồi trích các trường đó từ JSON-LD, gom theo giá trị và đếm. Một thực thể mà ra hai giá trị tên là thấy ngay số lượng trang thuộc mỗi bên. Điều kiện nghiệm thu: mỗi trường của thực thể chính chỉ có đúng một giá trị trên toàn website, và giá trị đó khớp thông tin công khai. Góc nhìn rộng hơn nằm ở mục Entity, hiểu đúng thực thể và quan hệ.
11. Tiêu chí 192: Schema khớp nội dung hiển thị
Schema chỉ được mô tả nội dung có thật, liên quan và người dùng nhìn thấy trên trang, nên không khai đánh giá, giá hay bất kỳ thông tin nào không hiện ra. Đây là tiêu chí Bắt buộc và cũng là tiêu chí duy nhất trong bài có thể dẫn tới hình phạt, vì khai sai ở đây thuộc nhóm vi phạm chính sách chứ không phải lỗi kỹ thuật.
Ba dạng vi phạm hay gặp theo thứ tự tần suất: khai aggregateRating khi trên trang không có đánh giá nào; khai FAQPage với những câu hỏi không hiện trên trang, thường vì plugin lấy nội dung từ một nơi khác; và khai giá khác giá đang hiển thị, thường vì schema lấy giá gốc còn trang hiển thị giá đã giảm.
Về đánh giá, có thêm một luật riêng cần biết: đánh giá do chính chủ thể tự đặt về mình, tức nội dung tự phục vụ, không đủ điều kiện cho đoạn đánh giá với Organization và LocalBusiness. Nên một khối năm sao tự khai trên trang chủ vừa không mang lại kết quả đặc biệt vừa là một khai báo sai.
Cách kiểm đúng, và nó không phải việc của công cụ: mở trang bằng mắt, rồi đọc từng trường trong JSON-LD và tìm thứ tương ứng trên trang. Công cụ kiểm tính hợp lệ, còn tính đúng thì chỉ người đọc trang mới xác nhận được. Luật gốc nằm ở chính sách dữ liệu có cấu trúc của Google. Điều kiện nghiệm thu: mọi trường trong schema truy được về một chỗ hiển thị trên trang.
12. Tiêu chí 193: Không có schema trùng hoặc mâu thuẫn
Không được để nhiều plugin hoặc theme cùng sinh schema cho một thực thể, dẫn tới node trùng, @id xung đột hay hai giá trị khác nhau cho cùng một trường. Cần phân biệt cho rõ: nhiều khối JSON-LD trên một trang là hợp lệ, thứ không hợp lệ là hai node cùng mô tả một thực thể mà nói khác nhau.
Nguyên nhân gần như luôn là số lượng nguồn sinh schema. Trên một website WordPress vận hành vài năm, schema có thể đến từ bốn nơi cùng lúc: plugin SEO chính, theme thương mại, một plugin đánh giá, và một đoạn mã dán vào phần header từ một hướng dẫn cũ. Mỗi nguồn tự khai Organization của mình, và không nguồn nào biết ba nguồn kia tồn tại.
Cách kiểm trên một trang: mở mã nguồn, đếm số khối JSON-LD, rồi đếm số node Organization và WebSite. Mong đợi là đúng một node cho mỗi thực thể. Cách kiểm trên toàn website là crawl và trích xuất, vì lỗi này thường chỉ xuất hiện ở một nhóm trang nào đó, ví dụ trang sản phẩm mới có thêm nguồn thứ hai.
Cách chữa là chọn MỘT chủ sở hữu của đồ thị rồi tắt các nguồn còn lại, không phải cố sửa cho bốn nguồn nói giống nhau. Phần lớn plugin SEO đều có công tắc tắt từng loại schema, và theme thương mại thường có tùy chọn tắt phần schema của nó. Điều kiện nghiệm thu: mỗi trang có đúng một node Organization, một WebSite, một node cấp trang, và không @id nào xuất hiện hai lần.
13. Một khối JSON-LD mẫu cho bốn node nền
Khối dưới đây là bốn node nền đã nối nhau bằng @id, đủ dùng cho một trang nội dung của bất kỳ website nào, và chỉ cần thay tên miền cùng thông tin thực thể. Nó cho thấy phần kết nối gọn hơn nhiều người tưởng: bốn dòng tham chiếu là xong.
{
 "@context": "https://schema.org",
 "@graph": [
 {
 "@type": "Organization",
 "@id": "https://ten-mien.com/#organization",
 "name": "Tên Thương Hiệu",
 "alternateName": "ten-mien.com",
 "url": "https://ten-mien.com/",
 "logo": { "@type": "ImageObject", "url": "https://ten-mien.com/logo.png" },
 "telephone": "+84xxxxxxxxx",
 "sameAs": ["https://www.linkedin.com/company/...", "https://www.facebook.com/..."]
 },
 {
 "@type": "WebSite",
 "@id": "https://ten-mien.com/#website",
 "url": "https://ten-mien.com/",
 "name": "Tên Thương Hiệu",
 "inLanguage": "vi-VN",
 "publisher": { "@id": "https://ten-mien.com/#organization" }
 },
 {
 "@type": "WebPage",
 "@id": "https://ten-mien.com/duong-dan/",
 "url": "https://ten-mien.com/duong-dan/",
 "name": "Tiêu đề của trang",
 "description": "Mô tả đúng nội dung trang này.",
 "inLanguage": "vi-VN",
 "isPartOf": { "@id": "https://ten-mien.com/#website" }
 },
 {
 "@type": "BreadcrumbList",
 "itemListElement": [
 { "@type": "ListItem", "position": 1, "name": "Trang chủ", "item": "https://ten-mien.com/" },
 { "@type": "ListItem", "position": 2, "name": "Danh mục", "item": "https://ten-mien.com/danh-muc/" },
 { "@type": "ListItem", "position": 3, "name": "Tiêu đề của trang" }
 ]
 }
 ]
}
Ba điểm đáng chú ý trong mẫu. Chỉ có MỘT @context ở ngoài cùng, không node nào tự khai lại. @id của WebPage là chính canonical của trang, không thêm mảnh nào. Và chặng cuối của breadcrumb bỏ trường item, vì nó là chính trang đang mở.
Khi trang có nội dung thuộc một loại cụ thể, thêm node đó vào cùng graph rồi nối bằng mainEntityOfPage trỏ về @id của WebPage. Không thay WebPage bằng nó, vì hai node trả lời hai câu khác nhau: trang này là gì, và nội dung chính trên trang này là gì.
14. Schema trên WordPress: chọn một chủ sở hữu của đồ thị
Trên WordPress, việc quan trọng nhất về schema không phải khai thêm node mà là quyết định nơi nào được phép sinh đồ thị, rồi tắt mọi nơi còn lại. Quyết định đó xử lý luôn tiêu chí 193 và phần lớn tiêu chí 191, tức hai trong ba tiêu chí Bắt buộc của bài.
Các plugin SEO lớn hiện nay đều sinh một @graph hoàn chỉnh với @id ổn định, gồm Organization hoặc Person, WebSite, WebPage và BreadcrumbList. Nghĩa là nếu đang dùng một plugin SEO được cấu hình đúng, bốn node nền của bài này đã có sẵn, và việc còn lại là kiểm giá trị cùng tắt các nguồn khác.
Danh sách nguồn cần đi rà theo thứ tự: plugin SEO thứ hai đang cài song song, phần schema tích hợp trong theme thương mại, các plugin thêm loại schema riêng, và những đoạn mã dán thủ công vào phần header. Nguồn cuối khó tìm nhất vì nó không nằm trong danh sách plugin; hãy tìm trong tùy chọn theme, trong plugin chèn mã, và trong các tệp con của theme.
Sau khi đã chọn một chủ sở hữu, phần cấu hình còn lại rất ngắn: khai đúng loại thực thể là tổ chức hay cá nhân, khai tên và logo thật, khai danh sách sameAs đã xác nhận, và bật breadcrumb sao cho phần hiển thị cùng phần schema đều do cùng một nguồn sinh ra. Điều kiện nghiệm thu: đúng một nguồn sinh đồ thị, và mọi nguồn khác đã tắt phần schema của nó.
15. Node nào không cần khai nữa và node nào đừng khai
Một phần đáng kể công việc schema hiện nay là gỡ những node từng được khuyên khai mà nay không còn tác dụng, vì Google đã thay đổi hoặc ngừng các tính năng tương ứng. Giữ chúng không gây lỗi, nhưng nó làm khối JSON-LD dài ra và làm người sau tưởng chúng đang có tác dụng.
Nhóm không cần nữa: SearchAction cho hộp tìm kiếm sitelinks, vì Google đã ngừng tính năng đó. HowTo cũng vậy, kết quả đặc biệt dạng hướng dẫn từng bước đã bị bỏ. Với FAQPage thì cần nói chính xác hơn: từ giữa năm 2023, Google giới hạn kết quả đặc biệt dạng FAQ cho các website chính phủ và y tế có thẩm quyền, nên với website thông thường nó gần như không còn hiện ra.
Nhưng FAQPage vẫn có lý do tồn tại, và đó là một lý do khác với lý do ban đầu: nó biến các cặp hỏi đáp trên trang thành dữ liệu đọc được bằng máy, tức có ích cho những nơi đọc đồ thị thay vì đọc chữ. Điều kiện đi kèm không đổi: câu hỏi và câu trả lời phải hiện trên trang, theo đúng tiêu chí 192.
Nhóm đừng khai: mọi node mô tả thứ không có trên trang. Cụ thể là aggregateRating khi không có đánh giá, Product khi trang không bán gì, Event khi không có sự kiện, và đánh giá tự phục vụ về chính tổ chức của mình. Danh sách loại còn được Google dùng nằm ở thư viện kết quả đặc biệt, và nên đọc lại mỗi vài tháng vì nó có thay đổi.
16. Quan hệ thật giữa schema và SEO
Schema không phải tín hiệu xếp hạng, và quan hệ thật giữa schema với SEO nằm ở hai chỗ khác: điều kiện để hiện kết quả dạng đặc biệt, và mức rõ ràng của thực thể khi máy đọc website. Nói schema làm tăng hạng là nói quá, nhưng nói nó vô ích cũng sai.
Chỗ thứ nhất, hiển thị: một số loại schema là điều kiện để kết quả tìm kiếm có thêm thành phần như đường dẫn phân cấp, ảnh, ngày hay khoảng giá. Đó là thay đổi ở HÌNH DẠNG của kết quả, không phải ở vị trí. Ảnh hưởng đi qua tỉ lệ nhấp chứ không đi qua thứ hạng, nên khi báo cáo hãy đo tỉ lệ nhấp của nhóm trang đó, đừng đo vị trí.
Chỗ thứ hai, hiểu thực thể: khi Organization có @id ổn định, logo thật và danh sách sameAs đã xác nhận, máy có đủ căn cứ nối website này với một thực thể đã biết bên ngoài. Việc đó không cho một con số nào tăng ngay, nhưng nó là nền cho phần nhận diện thương hiệu trong tìm kiếm. Chi tiết nằm ở mục Knowledge Graph Optimization.
Còn một giá trị đang lớn dần mà cần nói đúng mức: các nơi trả lời bằng AI đọc dữ liệu có cấu trúc thay vì phải suy lại từ HTML, nên một đồ thị sạch giúp chúng lấy đúng tên, đúng URL và đúng quan hệ. Đây là lợi ích về khả năng được đọc chính xác, KHÔNG phải một cam kết được trích dẫn. Ai hứa điều thứ hai là đang hứa thứ không ai kiểm được.
17. Ma trận kiểm tra theo tiêu chí và công cụ
Ma trận dưới đây gán từng tiêu chí cho công cụ đọc được nó, vì bốn công cụ trong bài trả lời bốn câu hỏi khác nhau và dùng sai công cụ là nhận một kết luận không liên quan. Cách dùng là đi theo cột công cụ, vì mỗi lần mở một công cụ thì kiểm được nhiều tiêu chí cùng lúc.
| Công cụ | Trả lời câu hỏi | Tiêu chí kiểm được |
|---|---|---|
| Schema Markup Validator | Khai có hợp lệ theo schema.org không | 184, 185, 187, 188, 190 |
| Rich Results Test | Có đủ điều kiện hiện kết quả đặc biệt không | 186, 192 |
| JSON-LD Playground | Tham chiếu @id có trỏ đúng đích không | 188, 190 |
| Meta Tag và Schema Checker | Trang này đang phát ra những gì | 184, 185, 187, 193 |
| Screaming Frog | Toàn website có nhất quán không | 189, 191, 193 |
| Mở trang bằng mắt | Schema có khớp nội dung thật không | 192 |
| Search Console | Google thấy lỗi gì trên thực tế | 186, 192 |
Hai hàng cuối là hai hàng không thay thế được bằng công cụ nào khác. Mở trang bằng mắt là phép duy nhất kiểm được tiêu chí 192, vì không công cụ nào biết một con số trong schema có hiện trên trang hay không. Còn Search Console là nơi duy nhất cho biết Google đang thấy gì, trên toàn bộ URL đã thu thập chứ không chỉ trang vừa thử.
18. Quy trình nghiệm thu và giám sát sau triển khai
Quy trình nghiệm thu schema nên đi theo mẫu trang chứ không theo URL, vì schema do template sinh ra, nên một lỗi trên một mẫu là một lỗi nhân lên bằng số trang dùng mẫu đó. Chọn đúng danh sách mẫu là phần quyết định chất lượng của cả lượt kiểm.
Trước khi triển khai, chốt bốn thứ: danh sách mẫu trang đại diện gồm trang chủ, trang danh sách, bài viết đơn, trang tĩnh và trang có loại nội dung đặc biệt nếu có; nguồn duy nhất được phép sinh đồ thị; giá trị chuẩn của từng trường thực thể; và phiên bản chuẩn của URL. Lưu khối JSON-LD của từng mẫu làm bản gốc để so.
Sau khi triển khai, chạy lại đúng chuỗi đó rồi thêm một lượt crawl toàn website để bắt ba thứ mà kiểm từng trang không thấy: URL lệch canonical, giá trị thực thể lệch giữa các nhóm trang, và node trùng chỉ xuất hiện ở một nhóm. Ba thứ này đều thuộc nhóm Bắt buộc hoặc Quan trọng.
Phần giám sát dài hạn thì đọc các báo cáo tăng cường trong Search Console, riêng báo cáo Breadcrumbs là báo cáo có ích nhất với bốn node nền. Điểm cần lưu ý về cách đọc: những báo cáo đó chạy theo dữ liệu Google đã thu thập nên chúng trễ vài ngày tới vài tuần, vì vậy đừng dùng chúng làm phép kiểm ngay sau khi triển khai. Dùng công cụ kiểm trực tiếp cho phần ngay, dùng Search Console cho phần theo dõi.
Một chỗ dễ hồi quy cần ghi vào lịch: mỗi lần cập nhật plugin SEO hoặc theme, hãy kiểm lại một mẫu trang. Đồ thị là thứ do plugin sinh, nên nó đổi theo plugin mà không ai sửa gì trong nội dung.
19. Công cụ Novaverb, tài liệu gốc và hướng thực hành
Bốn công cụ cho nhóm schema trả lời bốn câu hỏi khác nhau, nên hãy dùng cả bốn theo thứ tự từ phát ra cái gì, tới hợp lệ không, tới nối đúng không, tới đủ điều kiện hiện gì. Đọc đúng phạm vi từng công cụ là điều kiện để không kết luận sai theo cả hai hướng.
- Meta Tag và Schema Checker của Novaverb: rà nhanh thẻ tiêu đề, mô tả, heading và dữ liệu có cấu trúc mà một URL đang phát ra, dùng làm bước đầu để biết trang đang khai những gì.
- Schema Markup Validator: kiểm cú pháp và từ vựng schema.org, tức phần hợp lệ, không giới hạn theo loại Google dùng.
- Rich Results Test: kiểm phần đủ điều kiện hiện kết quả đặc biệt; không thấy loại nào đủ điều kiện KHÔNG phải lỗi nếu trang chỉ khai bốn node nền.
- JSON-LD Playground: xem dạng đã làm phẳng để kiểm mọi tham chiếu @id có trỏ đúng đích trong cùng graph.
Tài liệu nên giữ trong hồ sơ dự án: thư viện kết quả đặc biệt của Google, chính sách dữ liệu có cấu trúc, tài liệu breadcrumb và trang Organization trên schema.org. Dùng tài liệu gốc để phân biệt quy định của Google với từ vựng của schema.org, vì hai thứ đó không trùng nhau.
Nếu đang tìm lộ trình đào tạo SEO, có thể dùng checklist này làm bài thực hành: lấy khối mẫu ở mục 13, thay dữ liệu thật, kiểm qua bốn công cụ rồi crawl toàn website để soát nhất quán. Trang khóa học SEO giúp đối chiếu chương trình theo nền tảng hiện tại.
Muốn đưa audit schema vào quy trình SEO trên website thật, anh chị có thể xem phạm vi và cách học của khóa học SEO Master. Giá trị của bài thực hành nằm ở khả năng giải thích lỗi và chứng minh đã sửa bằng cùng một phép kiểm.
Kết hợp bài này với WordPress Hardening cùng mục tra cứu Rich Snippets và Features: một bài lo phần giữ website an toàn, một bài lo phần nói cho máy biết website là gì.
20. Câu hỏi thường gặp và kết luận
Các câu trả lời dưới đây giúp phân biệt từ vựng schema.org, quy định của Google và bằng chứng nghiệm thu trong WordPress. Khi gặp một kết quả không rõ, hãy quay về đúng công cụ trả lời câu hỏi đó trước khi đổi cấu hình plugin hoặc thêm node mới.
Schema có giúp tăng hạng không?
Không. Schema không phải tín hiệu xếp hạng. Nó làm hai việc khác: là điều kiện để kết quả tìm kiếm có thêm thành phần hiển thị, và giúp máy hiểu thực thể của website rõ hơn. Ảnh hưởng đi qua tỉ lệ nhấp và mức rõ ràng của thực thể, không đi qua vị trí.
Rich Results Test báo không tìm thấy loại nào, có phải lỗi không?
Không phải lỗi, nếu trang chỉ khai bốn node nền. Rich Results Test chỉ kiểm những loại Google dùng cho kết quả đặc biệt, và trong bốn node nền thì chỉ BreadcrumbList thuộc nhóm đó. Muốn kiểm tính hợp lệ của cả đồ thị thì dùng Schema Markup Validator, vì nó đọc toàn bộ từ vựng schema.org.
Có cần khai SearchAction nữa không?
Không cần khai SearchAction nữa. Node đó dùng để xin hộp tìm kiếm sitelinks, mà Google đã ngừng tính năng này. Giữ lại không gây lỗi nhưng cũng không còn tác dụng, nên hãy gỡ để khối JSON-LD chỉ còn những gì thật sự đang dùng.
Còn nên khai FAQPage không?
Nên, nhưng vì lý do khác trước. Từ giữa năm 2023 Google giới hạn kết quả đặc biệt dạng FAQ cho website chính phủ và y tế có thẩm quyền, nên website thường không còn hiện ra. Giá trị còn lại là biến cặp hỏi đáp thành dữ liệu máy đọc được, với điều kiện chúng hiện trên trang.
Nhiều khối JSON-LD trên một trang có sao không?
Bản thân số lượng khối thì không sao, Google chấp nhận nhiều khối. Vấn đề là hai node cùng mô tả một thực thể mà nói khác nhau, ví dụ hai Organization với hai tên. Hãy đếm số node cho mỗi thực thể, đừng đếm số khối.
@id nên đặt thế nào?
Đặt theo URL tuyệt đối rồi thêm một mảnh sau dấu thăng cho thực thể không phải một trang, ví dụ đuôi organization hoặc website. Thực thể là một trang thì đặt đúng canonical của trang. Đừng đặt vào đó những thứ hay đổi như tên hiển thị, số phiên bản hay ngày.
WebPage và Article có gộp làm một được không?
Không nên. Hai node trả lời hai câu khác nhau: trang này là gì, và nội dung chính trên trang này là gì. Giữ cả hai rồi nối bằng mainEntityOfPage, vì gộp là mất khả năng nói bài này được đăng ở trang này.
Plugin SEO đã sinh schema thì còn phải làm gì?
Ba việc. Kiểm giá trị thực thể có đúng và đủ chưa, tắt mọi nguồn khác đang sinh schema gồm theme và plugin phụ, và kiểm URL trong đồ thị có khớp canonical không. Plugin lo phần cấu trúc, ba việc kia không ai làm thay.
Kết luận: schema cơ bản chỉ gồm bốn node và bốn dòng tham chiếu, nhưng giá trị của nó nằm ở tính nhất quán chứ ở số lượng node. Khai đủ mười tiêu chí 184-193, chọn một nguồn duy nhất sinh đồ thị, và kiểm theo mẫu trang thay vì theo URL giúp SEO WordPress có một khối dữ liệu mà máy đọc xong biết chắc website này là của ai và gồm những gì.