

Google đã nói rằng lần cập nhật chính thức gần đây nhất, bao gồm sự ra mắt của thuật toán BERT, sẽ giúp hệ thống tìm kiếm hiểu được rõ hơn ý định ẩn đằng sau các truy vấn tìm kiếm của người dùng, và điều này sẽ giúp mang lại nhiều kết quả phù hợp hơn.
Phía Google cho hay, ở giai đoạn ra mắt thuật toán BERT sẽ ảnh hưởng đến 10% số lượt tìm kiếm bằng tiếng Anh và tiếp tục được hoàn thiện để tối ưu mức hiệu suất này đối với một số lượng ngôn ngữ ngày càng được mở rộng, có nghĩa là sự hiện diện và lượng truy cập tự nhiên của thương hiệu của bạn chắc chắn sẽ chịu một ảnh hưởng nhất định.
Bài viết này sẽ trình bày những câu hỏi và quan điểm rất quan trọng về thuật toán được Google giới thiệu như là “một trong những bước nhảy vọt lớn nhất trong lịch sử tìm kiếm”. Tìm hiểu thuật toán Google cùng tôi ở bài viết bên dưới.
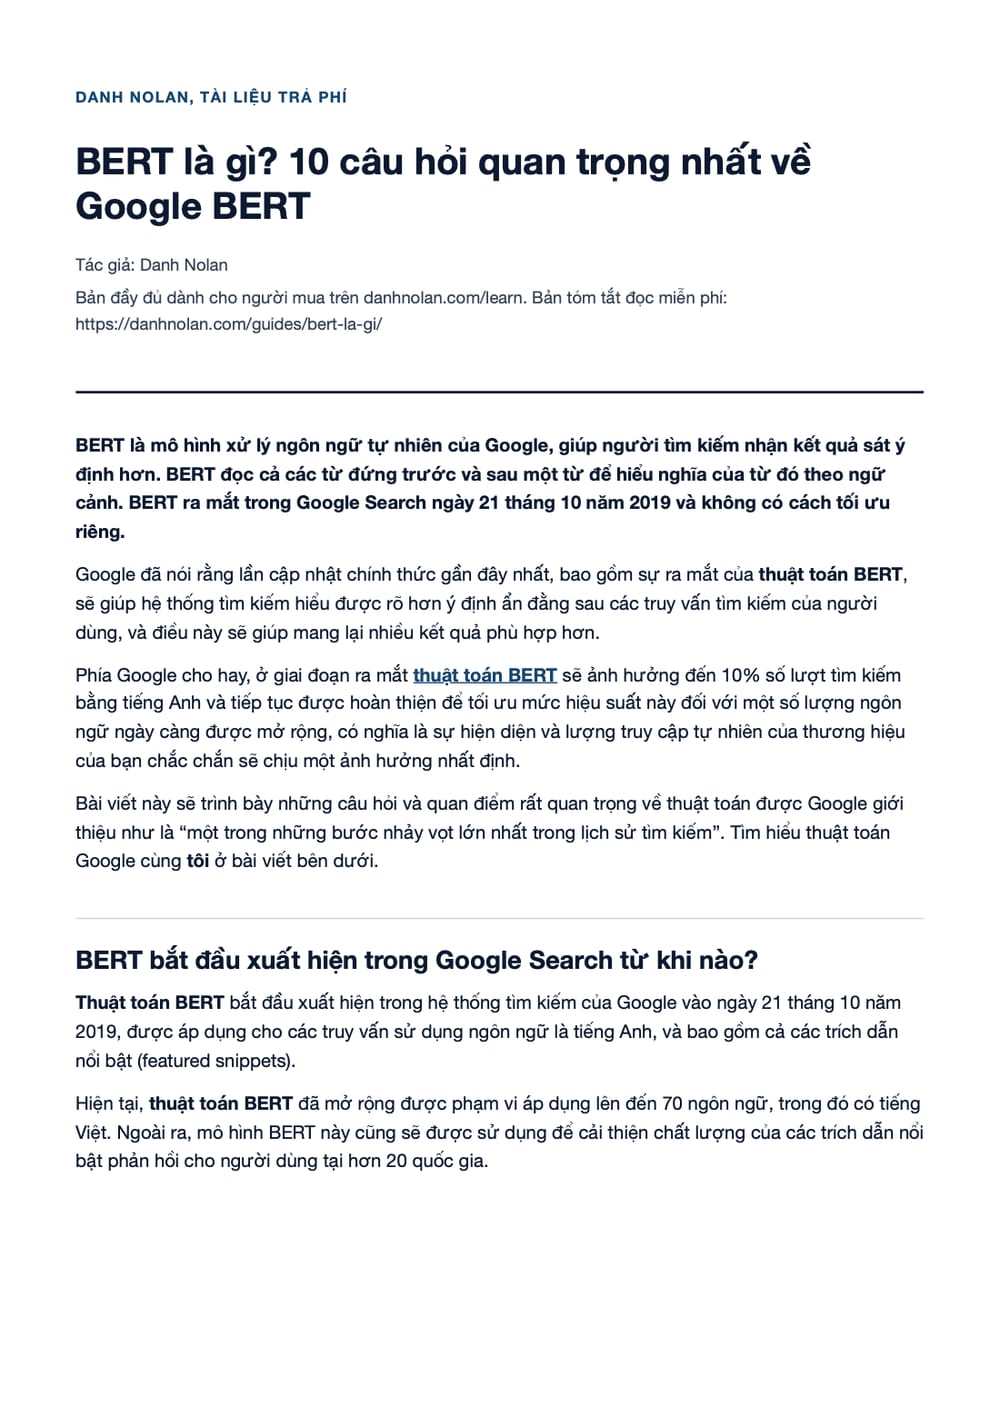
Tài liệu trả phí
Bản đầy đủ: BERT là gì? 10 câu hỏi quan trọng nhất về Google BERT
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 6.791 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 14 bước, bảng lỗi, mẫu, nghiệm thu (5 bảng)
- PDF: 17 trang, tải về
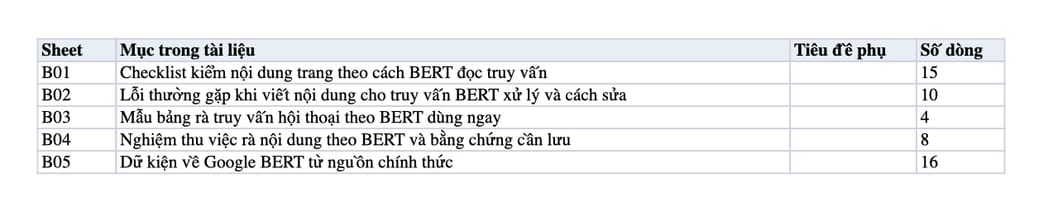
- Excel: 5 bảng và 16 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
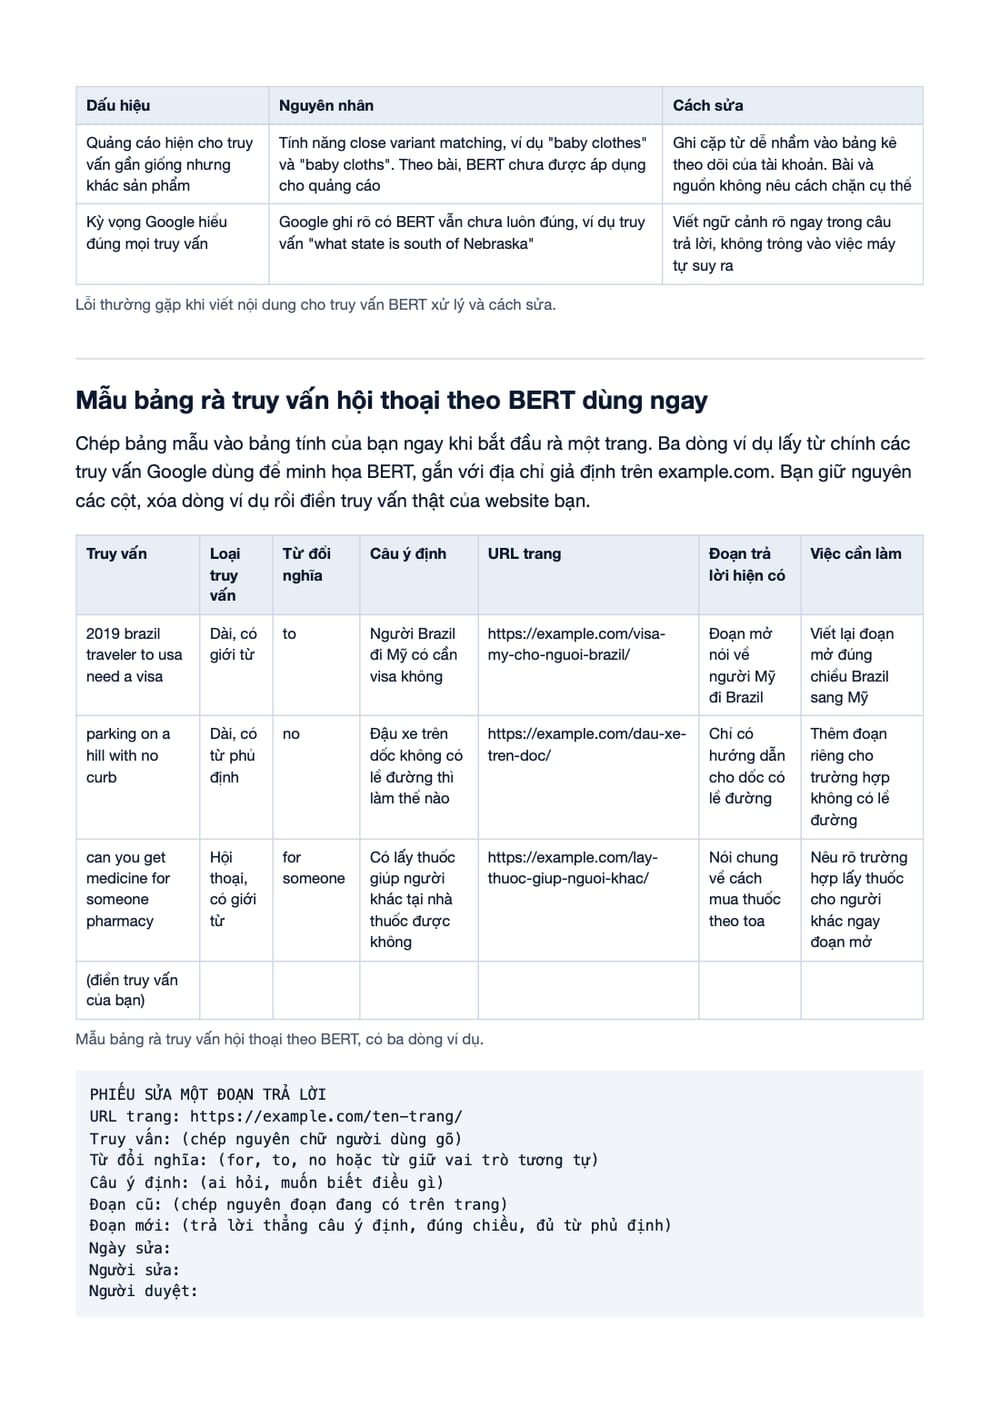
Xem trước bản đầy đủ: ba ảnh chụp từ chính tệp PDF và Excel bạn nhận sau khi mua.
BERT bắt đầu xuất hiện trong Google Search từ khi nào?
Thuật toán BERT bắt đầu xuất hiện trong hệ thống tìm kiếm của Google vào ngày 21 tháng 10 năm 2019, được áp dụng cho các truy vấn sử dụng ngôn ngữ là tiếng Anh, và bao gồm cả các trích dẫn nổi bật (featured snippets).
Hiện tại, thuật toán BERT đã mở rộng được phạm vi áp dụng lên đến 70 ngôn ngữ, trong đó có tiếng Việt. Ngoài ra, mô hình BERT này cũng sẽ được sử dụng để cải thiện chất lượng của các trích dẫn nổi bật phản hồi cho người dùng tại hơn 20 quốc gia.
BERT là gì?
BERT là từ viết tắt của “Bidirectional Encoder Representations from Transformers” (tạm dịch: Mô hình mã hóa hai chiều dữ liệu từ các khối Transformer). Đây là một phương pháp kỹ thuật được xây dựng dựa trên mô hình mạng mô phỏng theo hệ thống nơron thần kinh của con người (neural network) dùng để đào tạo trước (pre-train) quá trình xử lý ngôn ngữ tự nhiên.
Nói một cách đơn giản, thì nó có thể được sử dụng để giúp Google phân biệt rõ hơn ngữ cảnh của các từ xuất hiện trong truy vấn tìm kiếm.
Ví dụ, trong các cụm từ “nine to five” (từ 9 giờ sáng đến 5 giờ chiều) và “a quarter to five” (5 giờ kém 15 phút) thì từ “to” có hai ý nghĩa khác nhau, sự khác biệt này có thể rõ ràng đối với bạn và tôi nhưng lại khó nhận ra đối với các máy tìm kiếm. BERT được thiết kế để phân biệt những sắc thái ngữ nghĩa như vậy, từ đó giúp đưa ra những kết quả phù hợp và có liên quan hơn.
Google đã cung cấp mã nguồn mở cho BERT vào tháng 11 năm 2018. Điều này đồng nghĩa với việc bất cứ ai cũng có thể sủ dụng BERT để huấn luyện hệ thống xử lý ngôn ngữ của riêng họ cho việc trả lời các câu hỏi hoặc thực hiện các tác vụ khác.
Neural network là gì?
Theo thuật ngữ sinh học, nơron (neural) là đơn vị cơ bản cấu thành nên hệ thần kinh, các dây thần kinh khi nối với nhau sẽ hình thành nên mạng nơron. Trong lĩnh vực học sâu (deep learning) thì khái niệm “neural network” có thể được hiểu như là một mạng nơron nhân tạo có cấu trúc tương đồng với mạng nơron của não bộ được cấu thành bởi nhiều lớp (layer), mỗi lớp lại bao gồm nhiều đơn vị (unit) và tín hiệu nhập vào sẽ được xử lý qua từng lớp.
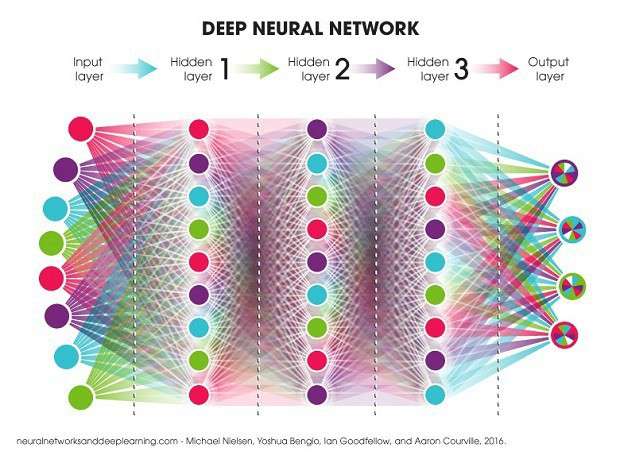
Một cách đơn giản, thì các mạng lưới neural network của các thuật toán được thiết kế cho việc nhận diện các kiểu mẫu dữ liệu (pattern). Phân loại các nội dung hình ảnh, nhận diện chữ viết tay và thậm chí dự đoán các xu hướng trong thị trường tài chính là những ứng dụng thực tế và phổ biến của neural network - đó là chưa kể đến các ứng dụng dùng trong việc tìm kiếm, chẳng hạn như các mô hình dự đoán lượt nhấp chuột.
Google giải thích rằng họ huấn luyện dựa trên các tập dữ liệu để nhận diện các kiểu mẫu và BERTđược đào tạo trước bằng việc sử dụng corpus (thuật ngữ mô tả một tập hợp các văn bản, ngôn ngữ đã được số hóa) dưới dạng văn bản thuần (plain text corpus) của Wikipedia.
Dưới đây là một ví dụ minh họa cho mạng lưới neural network:
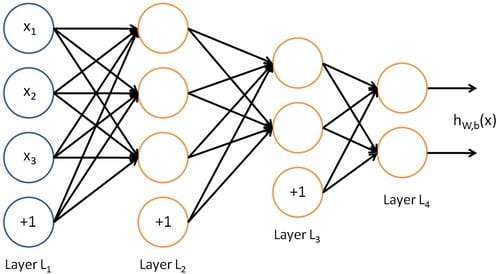
Theo hình ảnh này thì các dữ liệu đầu vào sẽ được xử lý qua các lớp để đến lớp cuối cùng. Layer 1 và 4 được gọi lần lượt là Input layer (nhận dữ liệu đầu vào) và Output layer (trả kết quả đầu ra), còn các layer giữa chúng được gọi là các Hidden layer (các lớp ẩn). Dữ liệu được xử lý qua mỗi lớp sẽ biểu diễn các đặc tính (feature) để lớp cao hơn ở phía sau có thể hiểu được, càng nhiều hidden layer thì quá trình học sâu càng hiệu quả hơn.
Ví dụ, trong trường hợp dùng công nghệ học sâu để nhận diện và xử lý nội dung của hình ảnh thì:
Bản đầy đủ của mục này có thêm: danh sách 2 dòng. Xem bản đầy đủ
Nếu bạn sử dụng một mẫu gồm hàng ngàn tấm ảnh và bạn “khai báo” cho neural network rằng một bức ảnh nào đó là khuôn mặt của bạn thì điều này có nghĩa là bạn đang dạy cho neural network biết đây là khuôn mặt của một người cụ thể. Sau quá trình học sâu thì hệ thống có thể nhận diện ra khuôn mặt của bạn trong bất kỳ bức ảnh nào.
Natural language processing là gì?
Quá trình xử lý ngôn ngữ tự nhiên (Natural language processing hay NLP) đề cập đến một nhánh của lĩnh vực trí tuệ nhân tạo (Artificial Intelligence hay AI) liên quan đến vấn đề xử lý về mặt ngôn ngữ học (linguistics), với mục đích làm cho các máy tính hiểu được cách thức mà con người giao tiếp tự nhiên với nhau.
Các ví dụ về những tiến bộ công nghệ trở nên khả thi nhờ vào NLP có thể kể đến như các công cụ nghiên cứu social listening (một phương pháp nghiên cứu thị trường trên Internet dựa trên các từ khóa được định trước để quản lý hình ảnh thương hiệu và theo dõi xem người khác đang nói gì về thương hiệu), các chatbot trả lời tự động hay công cụ gợi ý từ ngữ trên điện thoại thông minh.
Về bản chất, NLP không phải là một tính năng mới đối với các máy tìm kiếm. Tuy nhiên, BERT là một điển hình cho sự tiến bộ và phát triển của công nghệ NLP thông qua việc huấn luyện hai chiều (sẽ được trình bày cụ thể hơn bên dưới).
Thuật toán BERT hoạt động như thế nào?
Điểm đột phá của thuật toán BERTnằm ở khả năng huấn luyện các mô hình ngôn ngữ dựa trên toàn bộ tổ hợp các từ trong một câu hoặc truy vấn (huấn luyện hai chiều), thay vì cách thức huấn luyện truyền thống dựa trên thứ tự xuất hiện của các từ (từ trái qua phải hoặc kết hợp giữa trái qua phải và phải qua trái).
Thuật toán BERTcho phép mô hình ngôn ngữ học về ngữ cảnh của từ vựng dựa trên các từ xung quanh nó, thay vì chỉ dựa vào từ ngữ đứng trước hoặc ngay sau nó.
Google gọi BERT là công nghệ “có tính hai chiều rất sâu” bởi vì sự diễn giải ngữ cảnh của các từ bắt đầu từ “tầng đáy thấp nhất trong một mạng lưới neural network gồm rất nhiều tầng”.
“Chẳng hạn như từ “bank” trong tiếng Anh, nếu không có ngữ cảnh thì sẽ có cùng sự thể hiện về mặt từ ngữ như trong cụm “bank account” (tài khoản ngân hàng) và “bank of the river” (bờ sông). Các mô hình ngữ cảnh thay vào đó sẽ diễn dịch ý nghĩa của từng từ dựa trên những từ ngữ khác xuất hiện trong câu. Ví dụ, trong câu “I accessed the bank account” (Tôi đăng nhập vào tài khoản ngân hàng), thì mô hình ngữ cảnh đơn chiều (unidirectional contextual model) sẽ diễn giải từ “bank” dựa trên cụm “I accessed the” xuất hiện trước nó, mà không tính đến từ “account”. Tuy nhiên, BERT sẽ diễn giải từ “bank” bằng cách sử dụng cả ngữ cảnh đứng trước và sau từ đó - “I accessed the ... account”.
Google đã trình bày nhiều ví dụ về việc ứng dụng BERT trong hệ thống tìm kiếm có thể ảnh hưởng đến các kết quả ra sao. Giả sử đối với truy vấn “math practice books for adults” (sách bài tập toán cho người lớn), thì trước đây kết quả tìm kiếm tự nhiên có vị trí cao nhất sẽ là một quyển sách Toán dành cho khối lớp 6 đến lớp 8. Với việc ứng dụng BERT vào bộ máy hoạt động, Google sẽ trả về thông tin là một quyển sách có tựa đề “Math for Grownups” (Toán học cho người lớn) ở kết quả cao nhất trong số các kết quả tìm kiếm.
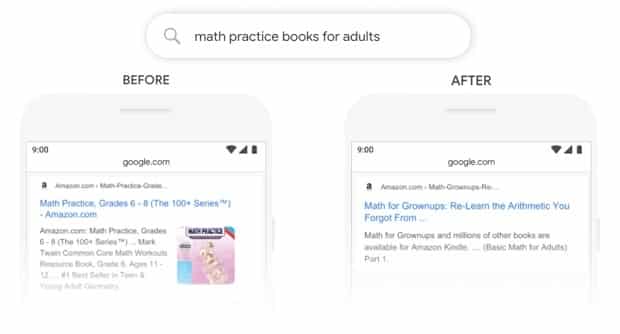
Bạn vẫn có thể còn thấy quyển sách dành cho lớp 6 đến lớp 8 này đang được xếp hạng trong các kết quả trả về hiện tại, nhưng có hai quyển sách Toán dành cho đối tượng người lớn hiện đang được xếp phía trên nó, trong đó có một quyển nằm trong phần trích dẫn nổi bật.
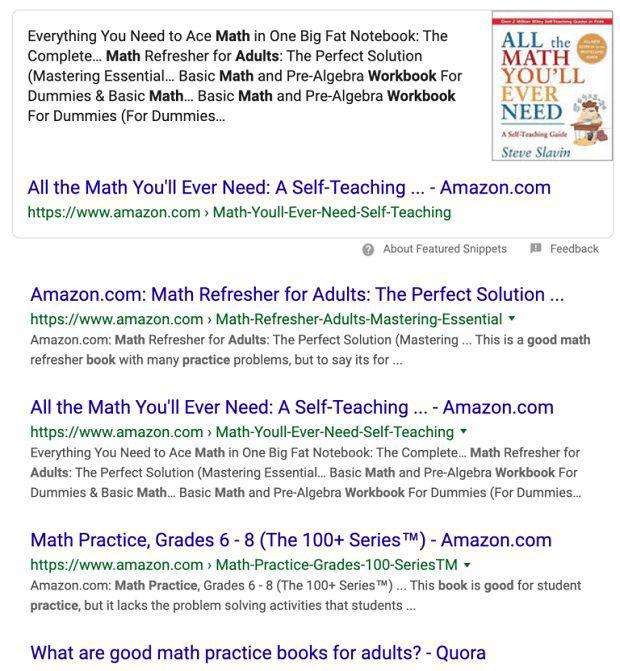
Sự thay đổi kết quả tìm kiếm giống như ví dụ trên phản ánh một cách hiểu mới trong việc giải nghĩa truy vấn khi áp dụng công nghệ BERT. Không phải những nội dung liên quan đến sách toán cho học sinh đang bị phạt, mà là các thông tin về sách toán nhắm đến đối tượng người lớn đang “trùng khớp” hơn với ý định của người tìm kiếm.
Google có dùng BERT để hiểu nghĩa của tất cả các tìm kiếm không?
Lúc đầu thì không, nay BERT giữ vai trò ở gần như mọi truy vấn tiếng Anh. Trong thời điểm mới ra mắt, thì người đại diện của Google đã phát biểu rằng BERT sẽ cải thiện việc diễn giải ý nghĩa của khoảng 10% lượt tìm kiếm bằng tiếng Anh tại Mỹ.
Trong một bài viết đăng tải trên blog, thì Google viết rằng “Đặc biệt đối với những truy vấn dài hơn, có tính hội thoại hơn, hoặc các tìm kiếm có chứa các giới từ như “for” và “to” (hai giới từ này trong tiếng Anh có rất nhiều cách hiểu khác nhau, tùy thuộc vào ngữ cảnh) ảnh hưởng nhiều đến ý nghĩa, thì hệ thống tìm kiếm sẽ có thể hiểu được ngữ cảnh của các từ trong truy vấn của bạn”.
Tuy nhiên, không phải tất cả truy vấn đều mang sắc thái giao tiếp/hội thoại (conversational) hoặc có chứa giới từ (preposition). Các tìm kiếm thương hiệu (branded search) và những cụm từ ngắn hơn là hai trong số các loại truy vấn có thể không cần đến quá trình xử lý ngôn ngữ tự nhiên của BERT.
BERT sẽ ảnh hưởng đến các trích dẫn nổi bật như thế nào?
Từ những ví dụ phía trên, tôi và bạn thấy BERT có thể ảnh hưởng đến những kết quả xuất hiện trong phần trích dẫn nổi bật nếu nó được áp dụng.
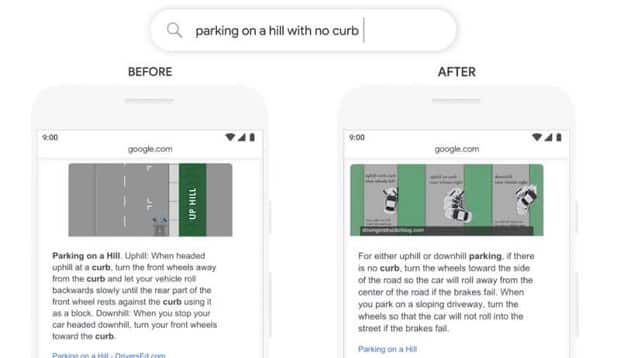
Trong một ví dụ khác dưới đây, Google so sánh hai đoạn trích dẫn nổi bật đối với truy vấn “parking on a hill with no curb” (đậu xe trên đồi không có lề đường) và giải thích rằng “Trước đây, một truy vấn như vậy sẽ làm cho hệ thống bị nhầm lẫn - chúng tôi đã quá tập trung vào từ “curb” (lề đường) và phớt lờ đi từ “no” (không), hệ thống không hiểu được từ đó có ý nghĩa then chốt như thế nào để phản hồi lại cho truy vấn một cách phù hợp.
Vậy nên tôi đã trả về những kết quả liên qua đến việc đậu xe trên một ngọn đồi có lề đường.”
Sự khác nhau giữa BERT và RankBrain?
Một số khả năng mà BERT có thể thực hiện trông có vẻ tương đồng với RankBrain - thuật toán ứng dụng trí tuệ nhân tạo đầu tiên của Google dùng để hiểu nghĩa các truy vấn tìm kiếm. Nhưng đây là hai thuật toán riêng biệt có thể được áp dụng để tác động đến các kết quả tìm kiếm.
Eric Enge - Quản lý điều hành cấp cao tại công ty Perficient Digital phát biểu rằng:
“Điều đầu tiên cần phải hiểu về RankBrain chính là nó vận hành song song với các thuật toán xếp hạng những kết quả tự nhiên thông thường, và nó được áp dụng để thực hiện một số điều chỉnh đối với các kết quả được tính toán bởi những thuật toán này.
Thuật toán RankBrain điều chỉnh các kết quả bằng cách nhìn vào truy vấn hiện tại và tìm kiếm những truy vấn tương tự đã diễn ra trước đây. Sau đó, nó đánh giá hiệu quả của những kết quả tìm kiếm đối với những truy vấn trong quá khứ này. Dựa trên những dữ liệu thu thập được, RankBrain có thể điều chỉnh lại kết quả đầu ra của các thuật toán xếp hạng kết quả tìm kiếm tự nhiên thông thường.”
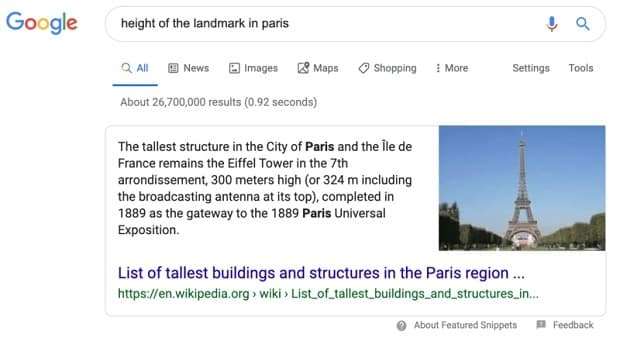
RankBraincũng giúp Google diễn dịch các truy vấn tìm kiếm để nó có thể nhận diện được các kết quả không chứa từ ngữ chính xác (exact word) trong truy vấn. Trong ví dụ bên dưới, Google có thể xác định rằng người dùng đang tìm kiếm thông tin về Tháp Eiffel, dù cho tên của ngọn tháp không xuất hiện trong truy vấn “height of the landmark in paris” (chiều cao của công trình tiêu biểu ở Paris).”
Eric Enge cũng trình bày thêm rằng “BERT hoạt động theo một cơ chế hoàn toàn khác biệt. Các thuật toán truyền thống cố gắng nhìn vào các nội dung trên một trang để hiểu xem nó nói về chủ đề gì và nó có thể liên quan đến những nội dung nào.
Tuy nhiên, các thuật toán xử lý ngôn ngữ tự nhiên truyền thống chỉ có khả năng nhìn vào nội dung đứng trước một từ HOẶC nội dung đứng sau một từ để tiếp nhận thêm ngữ cảnh nhằm giúp nó hiểu rõ hơn về ý nghĩa của từ đó. Chính yếu tố “hai chiều” của BERT là điều làm nó trở nên khác biệt.”
Khác với các thuật toán truyền thống, BERT sẽ nhìn vào các nội dung đứng trước VÀ sau một từ giúp củng cố sự hiểu biết của nó về ý nghĩa và sự liên quan của từ ngữ đó. “Đây là một tiến bộ có tính then chốt trong quá trình xử lý ngôn ngữ tự nhiên vì việc giao tiếp của con người về bản chất vốn dĩ cũng rất đa tầng và phức tạp.”
Cả hai thuật toán BERT và RankBrain đều được Google áp dụng để xử lý các truy vấn và nội dung web page, nhằm mục đích thấu hiểu hơn về ý nghĩa của những từ ngữ có trong đó.
Tuy nhiên, BERT ra đời không nhằm mục đích để thay thế RankBrain. Google có thể sẽ sử dụng nhiều phương pháp khác nhau để hiểu về một truy vấn, có nghĩa là BERT vẫn có thể được áp dụng riêng biệt, cùng với các thuật toán khác của Google, song song với RankBrain, và bất cứ tổ hợp nào hoặc không giữa chúng, tùy thuộc vào cụm từ tìm kiếm.
RankBrain là thuật toán AI mà Google sử dụng để sắp xếp kết quả tìm kiếm. Nó cũng giúp Google xử lý và hiểu các truy vấn tìm kiếm. Đây là một hệ thống trí tuệ nhân tạo Machine-learning, như vậy thuật toán xếp hạng của Google không còn do con người quản lý.
RankBrain là gì? Vai trò của RankBrain trong kết quả tìm kiếm
BERT còn ảnh hưởng đến sản phẩm nào khác của Google không?
Google thông báo rằng BERT chỉ được áp dụng đối với Google Search. Tuy nhiên, nó cũng sẽ có ảnh hưởng nhất định đến sản phẩm trợ lý cá nhân ảo Google Assistant. Khi các truy vấn được thực hiện trên Google Assistant “kích hoạt” BERT trả về các trích dẫn nổi bật hoặc các trang web từ Google Search, thì các kết quả này có thể bị tác động bởi BERT.
Google cũng đã chia sẻ thuật toán BERT hiện tại chưa được áp dụng đối với các quảng cáo, nhưng nếu nó được tích hợp trong tương lai, thì điều này có thể giúp hạn chế đi một số trường hợp “hiểu sai” khi áp dụng tính năng trùng khớp biến thể gần chính xác với từ khóa (bad close variants matching) gây phiền nhiễu cho các nhà quảng cáo.
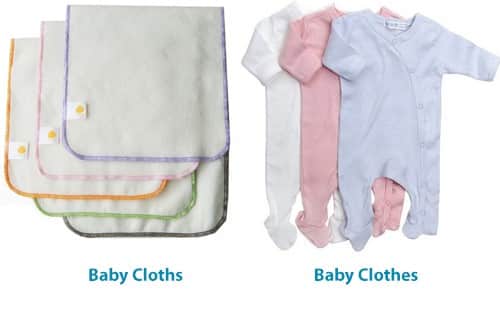
Ví dụ “baby clothes” (quần áo cho trẻ sơ sinh) và “baby cloths” (khăn cho trẻ sơ sinh) là hai cụm từ khóa đại diện cho hai sản phẩm khác nhau và đề xuất những nội dung khác nhau.
Giả sử khi triển khai quảng cáo Google Adwords, khách hàng sẽ trả phí cho Google dưới hình thức đấu giá để trang của họ xuất hiện trong các kết quả tìm kiếm ở khu vực quảng cáo đối với những từ khóa nhất định. Cụm từ “baby clothes” được chọn làm từ khóa kích hoạt (trigger word) để hiển thị một web page nào đó trong các kết quả quảng cáo trên SERPs.
Cùng với việc áp dụng tính năng trùng khớp biến thể gần chính xác với từ khóa (close variant matching), khi người dùng nhập vào truy vấn “baby cloths”, trang được kích hoạt bởi từ khóa “baby clothes” đó cũng có thể xuất hiện trong các kết quả quảng cáo.
Tuy nhiên, đối với những người kinh doanh khăn cho trẻ sơ sinh, tỉ lệ nhấp chuột và tỉ lệ chuyển đổi có thể bị giảm xuống.
Tối ưu hóa cho thuật toán BERT như thế nào?
Danny Sullivan - đồng sáng lập của trang Search Engine Land chia sẻ “Không có gì để tối ưu cho BERT cả, và cũng không có gì để mọi người phải tư duy lại cả. Những nguyên lý nền tảng mà tôi và bạn theo đuổi để tạo ra kết quả tích cực cho những nội dung tốt vẫn không thay đổi.”
Tối ưu không có điểm dừng tự nhiên, nên thứ quyết định hiệu quả là biết dừng đúng chỗ và chuyển sang việc khác. Khóa Học SEO Master đi vào cách chọn.
Từ trước đến nay, lời khuyên của Google nếu muốn thăng hạng tốt luôn là hãy nghĩ đến người dùng và tạo ra các nội dung thỏa mãn ý định tìm kiếm của họ. Vì BERT được thiết kế để diễn giải ý định đó, vậy nên không có gì khó hiểu khi Google vẫn nhất quán với quan điểm của họ: cung cấp cho người dùng đúng những gì họ muốn.
“Tối ưu hóa” giờ đây nghĩa là bạn có thể tập trung và đầu tư hơn vào việc viết nên những nội dung tốt, rõ ràng, thay vì thỏa hiệp giữa việc tạo ra nội dung cho đối tượng mục tiêu của bạn và việc đặt các từ ngữ trong câu như thế nào cho các bộ máy.
BERT là thuật toán được Google cho ra mắt năm 2019 và đã trở thành một trong những thuật toán quan trọng nhất. Mức độ thấu hiểu của bạn về BERT sẽ là tiền đề để bạn có những bước chuẩn bị vững chắc cho thành công trong tương lai. Bạn nhớ đón đọc những bài viết sắp tới về thuật toán BERT cùng Hướng Nghiệp Á Âu.
Bước tiếp theo
Muốn tự làm được việc này trên website của bạn?
SEO Master hướng dẫn làm SEO trong 24 buổi, từ tư duy nền tảng tới triển khai và đo lường trên website thật.
Tài liệu trả phí
Bản đầy đủ: BERT là gì? 10 câu hỏi quan trọng nhất về Google BERT
Phần đọc miễn phí giữ trọn phần chữ của bài. Bảng, danh sách bước và checklist của bài nằm trong bản đầy đủ, cùng bộ tài nguyên làm theo viết riêng cho bản bán, kèm tệp PDF và Excel.
- Đọc trên trang học: trọn 6.791 chữ
- Bộ tài nguyên làm theo: checklist, quy trình 14 bước, bảng lỗi, mẫu, nghiệm thu (5 bảng)
- PDF: 17 trang, tải về
- Excel: 5 bảng và 16 dòng checklist có cột đánh dấu
- Quyền dùng: mua một lần, sở hữu vĩnh viễn
399.000đ thanh toán 16 USD qua PayPal hoặc thẻ Visa, Mastercard
Cách viết nội dung phù hợp với thuật toán BERT
Các bước giúp bạn viết nội dung rõ ràng, sát ý định tìm kiếm của người dùng, để Google hiểu đúng ngữ cảnh khi áp dụng BERT vào truy vấn.
- Bỏ tìm mẹo tối ưu riêngKhông tìm mẹo kỹ thuật riêng cho BERT, vì Google cho biết không có gì để tối ưu cho BERT và những nguyên lý nền tảng cho nội dung tốt vẫn không thay đổi.
- Xác định ý định tìm kiếmĐọc kỹ truy vấn người dùng gõ vào và xác định họ thật sự muốn tìm gì, vì BERT được thiết kế để diễn giải đúng ý định đó.
- Viết cho người đọc trướcTập trung tạo nội dung thỏa mãn ý định tìm kiếm của đối tượng mục tiêu, không thỏa hiệp cách đặt từ ngữ trong câu để chiều các bộ máy.
- Viết câu rõ ràng, tự nhiênGiữ đủ các từ nhỏ như giới từ “for”, “to” hay từ “no”, vì BERT đọc cả từ đứng trước và sau để hiểu nghĩa theo ngữ cảnh.
- So sánh kết quả tìm kiếmGõ thử các truy vấn dài, có tính hội thoại liên quan đến chủ đề và xem trang nào đang xếp trên, để biết nội dung nào khớp ý định người tìm kiếm hơn.
Câu hỏi thường gặp về BERT
Giải đáp trực tiếp các câu hỏi thường gặp về BERT dựa trên dữ liệu triển khai thực tế, quy trình kiểm thử kỹ thuật và kinh nghiệm thực chiến trên website thật để tối ưu hiệu quả tìm kiếm.
Vì sao lượt truy cập tự nhiên có thể thay đổi sau khi Google áp dụng BERT?
Lượt truy cập có thể thay đổi vì BERT giúp Google hiểu rõ hơn ý định đằng sau truy vấn, nên kết quả khớp ý định hơn sẽ được đưa lên. Ở giai đoạn ra mắt, BERT ảnh hưởng đến 10% số lượt tìm kiếm bằng tiếng Anh, và sự hiện diện của thương hiệu chắc chắn chịu một ảnh hưởng nhất định.
Trang bị tụt hạng sau khi có BERT có phải đang bị Google phạt không?
Không hẳn. Với truy vấn “math practice books for adults”, sách toán cho học sinh lớp 6 đến lớp 8 vẫn được xếp hạng, nhưng sách toán cho người lớn khớp ý định hơn nên được đưa lên trên. Nội dung bị đẩy xuống vẫn không bị phạt, chỉ có nội dung khác trùng khớp ý định người tìm kiếm hơn.
Đặt từ ngữ trong câu để chiều bộ máy có còn cần thiết khi có BERT không?
Không còn cần thiết. BERT được thiết kế để diễn giải ý định tìm kiếm theo ngữ cảnh của cả câu, nên điều quyết định là nội dung tốt, rõ ràng, thỏa mãn ý định người dùng. Bạn có thể tập trung viết cho đối tượng mục tiêu, không cần thỏa hiệp cách đặt từ ngữ cho các bộ máy.
Vì sao máy tìm kiếm trước đây hay hiểu sai truy vấn có từ phủ định như “no”?
Hệ thống cũ quá tập trung vào từ chính và bỏ qua những từ nhỏ mang ý nghĩa then chốt. Với truy vấn “parking on a hill with no curb”, Google từng phớt lờ từ “no” và trả về kết quả đậu xe trên đồi có lề đường. BERT đọc cả từ đứng trước và sau nên hiểu đúng hơn.
Một mạng neural network gồm những lớp nào và mỗi lớp làm gì?
Mạng neural network gồm nhiều lớp, mỗi lớp có nhiều đơn vị và tín hiệu nhập vào được xử lý qua từng lớp. Input layer nhận dữ liệu đầu vào, Output layer trả kết quả đầu ra, các lớp giữa gọi là Hidden layer. Càng nhiều hidden layer thì quá trình học sâu càng hiệu quả hơn.
Loại truy vấn nào được hưởng lợi nhiều từ BERT và loại nào ít cần đến?
Truy vấn dài hơn, có tính hội thoại hơn, hoặc chứa giới từ như “for” và “to” vốn ảnh hưởng nhiều đến ý nghĩa sẽ được hưởng lợi nhiều. Ngược lại, tìm kiếm thương hiệu và những cụm từ ngắn hơn có thể không cần đến quá trình xử lý ngôn ngữ tự nhiên của BERT.
BERT hiện được áp dụng cho bao nhiêu ngôn ngữ và đã có tiếng Việt chưa?
BERT đã mở rộng phạm vi áp dụng lên đến 70 ngôn ngữ, trong đó có tiếng Việt. Lúc ra mắt ngày 21 tháng 10 năm 2019, BERT chỉ áp dụng cho truy vấn tiếng Anh. BERT cũng được dùng để cải thiện trích dẫn nổi bật tại hơn 20 quốc gia.
Google công bố mã nguồn mở của BERT từ khi nào và để làm gì?
Google cung cấp mã nguồn mở cho BERT vào tháng 11 năm 2018. Nhờ vậy, bất cứ ai cũng có thể dùng BERT để huấn luyện hệ thống xử lý ngôn ngữ của riêng họ cho việc trả lời câu hỏi hoặc thực hiện các tác vụ khác. BERT được đào tạo trước bằng văn bản thuần của Wikipedia.
BERT là viết tắt của cụm từ gì trong tiếng Anh?
BERT là viết tắt của Bidirectional Encoder Representations from Transformers, tạm dịch là mô hình mã hóa hai chiều dữ liệu từ các khối Transformer. BERT là phương pháp dựa trên mạng neural network, để đào tạo trước quá trình xử lý ngôn ngữ tự nhiên, giúp Google phân biệt rõ hơn ngữ cảnh các từ trong truy vấn.
Người làm SEO nên bắt đầu thích nghi với BERT từ đâu?
Người làm SEO nên bắt đầu thích nghi với BERT từ ý định tìm kiếm của người dùng. BERT không có cách tối ưu riêng, nên việc cần làm là viết nội dung tốt, rõ ràng, trả lời đúng điều người tìm kiếm muốn, và viết câu tự nhiên cho người đọc trước khi nghĩ đến bộ máy.
BERT có thay thế thuật toán RankBrain của Google không?
BERT không thay thế RankBrain. Google có thể dùng nhiều phương pháp để hiểu một truy vấn, nên BERT có thể chạy riêng, cùng các thuật toán khác, song song với RankBrain, hoặc kết hợp tùy cụm từ tìm kiếm. RankBrain là thuật toán trí tuệ nhân tạo đầu tiên của Google dùng để hiểu nghĩa truy vấn.
Huấn luyện hai chiều trong thuật toán BERT nghĩa là gì?
Huấn luyện hai chiều trong BERT nghĩa là mô hình học ngữ cảnh của một từ dựa trên các từ xung quanh, cả đứng trước lẫn đứng sau. Các mô hình truyền thống chỉ đọc theo thứ tự xuất hiện của từ. Ví dụ, BERT hiểu từ “bank” trong “I accessed the bank account” nhờ cả từ “account” đứng sau.
Làm tiếp trên chính website của bạn
Chọn theo điều bạn đang cần: người soi website, nền tảng để tự làm, hay người kèm tới nơi.
Phân tích SEO và GEO Online
Tìm đúng chỗ website đang nghẽn, bàn giao thứ tự sửa và bản đồ nội dung theo DLN™. Học tiếp Mentor thì phí này được trừ vào học phí.
Xem phạm vi phân tíchKhóa học SEO cơ bản Online
6 buổi online về Technical và On-page, đủ nền tảng để tự rà và sửa website của bạn.
Xem lộ trình họcMentor SEO 1 kèm 1 Online
12 buổi trong 4 tuần, làm trực tiếp trên website của bạn cùng Danh Nolan.
Xem cách kèm